 人工精选
黑马程序员ai大模型第三期
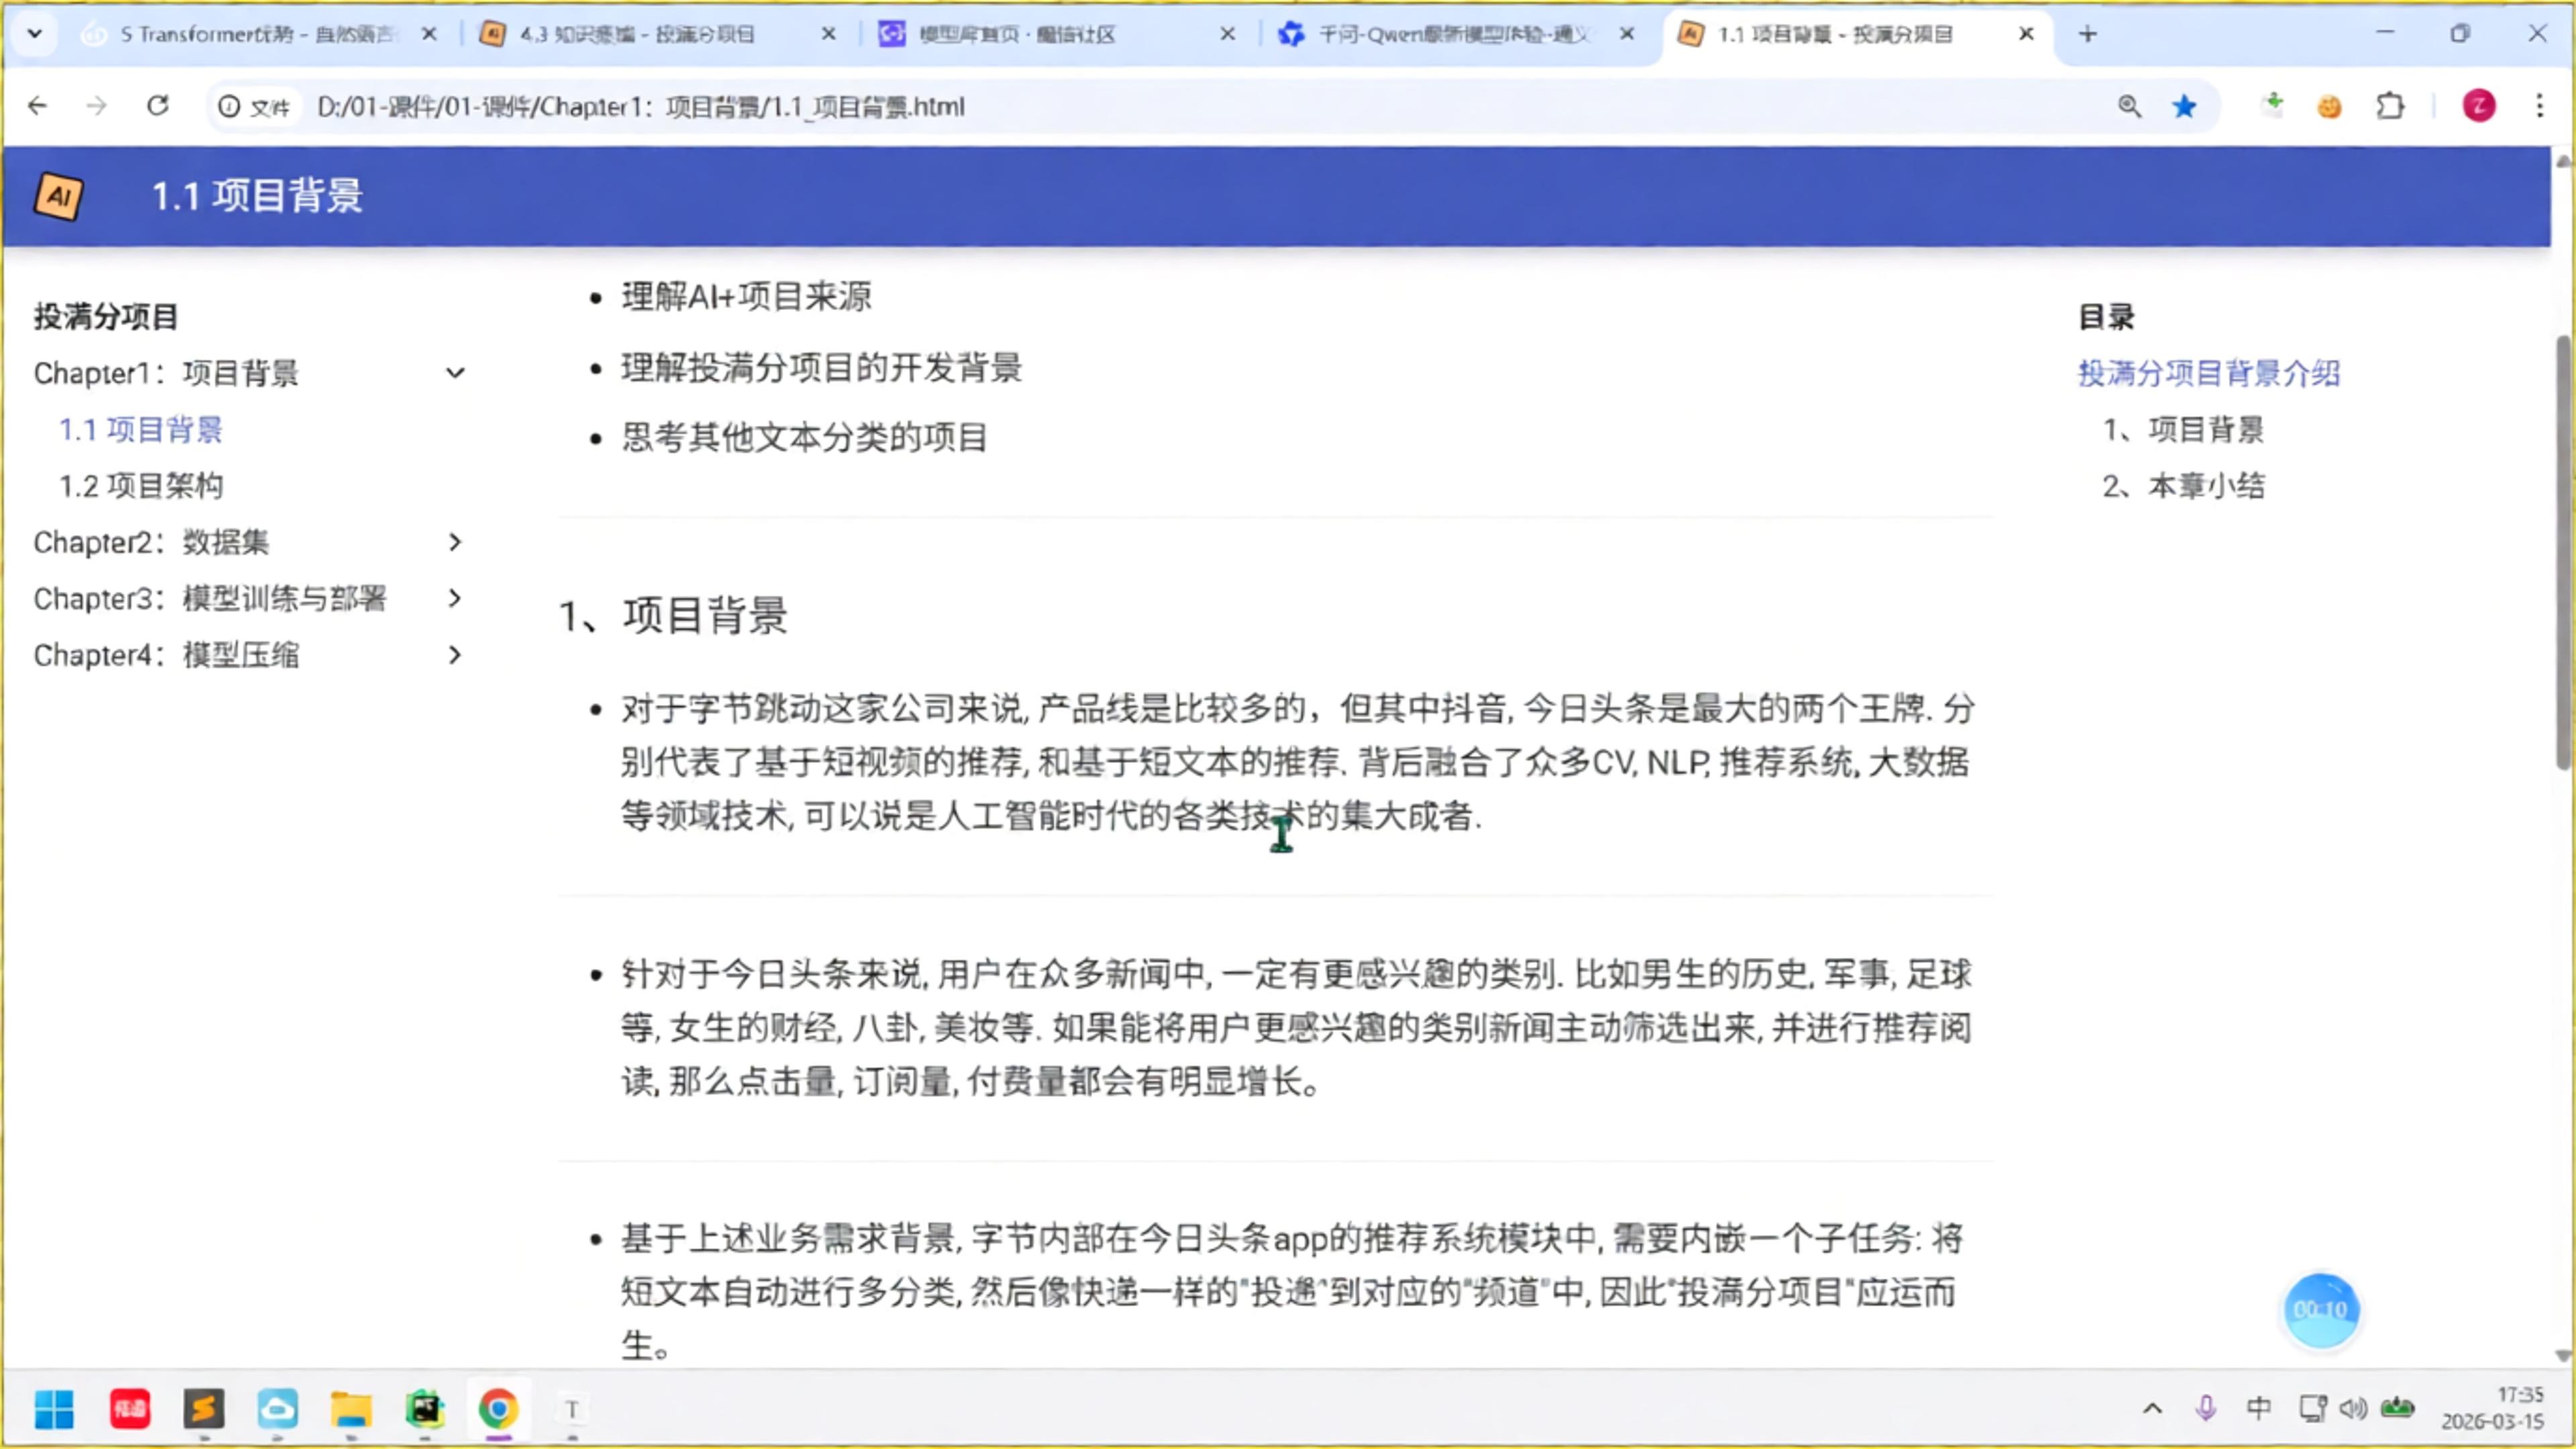
课程定位:聚焦垂直行业的落地实战 这套资料的核心并非通用的大模型理论科普,而是针对金融垂直领域的应用落地。在当前的就业市场中,单纯的“提示词工程师”往往缺乏护城河,而能够将大模型能力与具体业务场景(如金融信息抽取、文本分类、风险匹配)相结合的开发人员则更为稀缺。本课程的设置逻辑非常务实:从主流开源模
会员可免费下载本篇月会员可免费领取。
开通会员 ›会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
课程定位:聚焦垂直行业的落地实战
这套资料的核心并非通用的大模型理论科普,而是针对金融垂直领域的应用落地。在当前的就业市场中,单纯的“提示词工程师”往往缺乏护城河,而能够将大模型能力与具体业务场景(如金融信息抽取、文本分类、风险匹配)相结合的开发人员则更为稀缺。本课程的设置逻辑非常务实:从主流开源模型的选型讲起,迅速切入代码层面的实现细节,重点攻克非结构化数据向结构化数据转化的难点。它解决的是学员在面对真实企业级项目时,不知道如何调用模型、如何处理脏数据、如何评估输出结果准确性的痛点。
值得注意的是,课程中包含了 ChatGLM2-6B 等开源模型的权重文件及量化配置脚本,这意味着学习过程不仅仅是调 API,还涉及本地部署与模型微调的基础认知。这种“端到端”的闭环训练,对于理解大模型在生产环境中的资源消耗和性能边界至关重要。对于求职者而言,这不仅是学习一门技术,更是积累一个可演示的项目经验,证明你具备将 AI 能力转化为实际生产力的工程化思维。
前置要求与适合人群
本课程不适合零基础或非 IT 背景的纯业务人员零门槛速成,建议学习者具备 Python 基础编程能力,并熟悉基本的线性代数和概率论概念。你需要能够独立运行 Jupyter Notebook 或类似的 Python 开发环境,因为课程中的代码实战环节较多,且涉及数据处理库的使用。
最适合的人群是两类:一是有一定开发基础但希望转型大模型应用开发的初级程序员,希望通过一个完整的垂直行业案例打通从数据清洗到模型调用的全流程;二是正在准备相关岗位的转行者,需要一份有深度的项目经历来填补简历空白。如果你已经熟练掌握 LangChain 等框架的高阶用法,可能会觉得部分基础讲解略显冗余,但对于想要夯实底层原理的学习者来说,这些内容正是构建知识体系所必需的基石。
学习路径建议与资料配合
建议按照以下顺序高效利用现有资料,避免陷入片段的知识点收集而忽略整体脉络:
- 第一阶段:建立全局视野。先阅读《LLM主流开源大模型介绍》讲义和《大模型应用工具实战》PPT,不要急于看视频,先明确当前市场上有哪些主流选择,以及工业界常用的工具体系,建立正确的技术选型观。
- 第二阶段:掌握核心技能——信息抽取。这是本课程的难点和重点。结合《LLM实现金融信息抽取》的讲义与对应的视频代码,动手复现从非结构化金融新闻中提取实体(如人名、机构、金额)的过程。这一步务必亲手写代码,因为错误处理和时间复杂度优化是面试高频考点。
- 第三阶段:进阶应用——分类与匹配。在学习完抽取后,通过《LLM实现金融文本分类》和《LLM实现金融信息匹配》这两个案例,理解如何对已有数据进行标签化处理。此时可以利用提供的 Dataset-of-financial-news-classification 数据集进行本地实验,观察不同模型在处理长文本时的表现差异。
- 第四阶段:补充与输出。最后翻阅《大模型提示工程指南》提升 Prompt 编写质量,同时参考赠送的简历模板,将你在前几个阶段完成的金融信息抽取与分类项目进行包装,形成清晰的技术栈描述和成果展示,为求职做准备。
整套资料的配合逻辑是从“懂模型”到“用模型”再到“做好模型”,请保持耐心,注重每一个代码案例的理解而非仅仅复制运行,这样才能真正将知识内化为你的职场竞争力。
课程目录
AI大模型 赠送资料2 条
- 11本AI大模型相关电子书.zip [309.6 MB]
- 简历模板.zip [2.2 MB]
01-讲义1 条
- 01-大模型提示工程指南.pdf [1.3 MB]
01-讲义2 条
- 05-LLM实现金融信息匹配.pdf [303.2 KB]
- 04-LLM实现金融信息抽取.pdf [330.9 KB]
03-视频3 集
- 03-文本匹配.mp4 [58.9 MB]
- 01-信息抽取.mp4 [104.4 MB]
- 02-信息抽取2.mp4 [34.7 MB]
01-讲义1 条
- 01-LLM主流开源大模型介绍.pdf [11.4 MB]
1.讲义1 条
- 大模型应用工具实战01.pptx [36.3 MB]
01-讲义1 条
- 星火大模型(博学谷).pdf [12.1 MB]
Dataset-of-financial-news-classification3 条
- Fiance_train_data.csv [912.4 KB]
- Fiance_test_data.csv [159.9 KB]
- translate_in_many_style.zip [79.3 MB]
01-讲义2 条
- 02-金融行业动态方向评估项目.pdf [583.3 KB]
- 03-LLM实现金融文本分类.pdf [360.8 KB]
chatglm2-6b-int48 条
- MODEL_LICENSE [2.3 KB]
- modeling_chatglm.py [53.6 KB]
- quantization.py [2.5 MB]
- tokenizer.model [994.5 KB]
- tokenization_chatglm.py [9.8 KB]
- config.json [1.1 KB]
- tokenizer_config.json [243.0 B]
- configuration_chatglm.py [2.2 KB]
01-讲义_09151359024 条
- 03-LLM实现金融文本分类.pdf [360.8 KB]
- 02-金融行业动态方向评估项目.pdf [583.3 KB]
- 1.环境要求.pdf [110.8 KB]
- 趋动云使用《补充》.pdf [3.1 MB]
02-代码3 条
- finance_text_matching.py [3.1 KB]
- finance_classify.py [4.4 KB]
- finance_ie.py [4.9 KB]
1.讲义1 条
- 大模型应用工具实战02.pptx [19.9 MB]
01-讲义2 条
- 02-LLM主要架构介绍.pdf [7.7 MB]
- 01-LLM基础知识.pdf [11.4 MB]
02-代码5 条
- 03-PPL.py [365.0 B]
- 02-rouge.py [178.0 B]
- 01-bleu.py [545.0 B]
- 大语言模型的背景.xmind [159.6 KB]
- 大模型.xmind [214.3 KB]
01-讲义2 条
- 01-大模型prompt-Tuning方法入门.pdf [8.2 MB]
- 02-大模型prompt-Tuning方法进阶.pdf [9.2 MB]
01-讲义2 条
- 02-ChatGPT模型原理介绍.pdf [14.3 MB]
- 01-LLM主要架构介绍.pdf [7.7 MB]
01-讲义2 条
- 01-AI Agents的开发应用.pdf [1.1 MB]
- 01-LangChain基础知识入门.pdf [851.8 KB]
Memory_module3 条
- demo_memory.py [225.0 B]
- demo_message_dict.py [428.0 B]
- demo_up_memory.py [675.0 B]
Prompts_module2 条
- demo_few_shot.py [1.3 KB]
- demo_zero_shot.py [624.0 B]
Agents_module1 条
- demo_agent.py [1000.0 B]
Models_module3 条
- demo_chat_models.py [428.0 B]
- demo_llms.py [313.0 B]
- demo_embedding_models.py [622.0 B]
Chains_module2 条
- demo_use_LLMChain.py [615.0 B]
- demo_use_simpleChain.py [1.1 KB]
Indexes_module6 条
- 衣服属性.txt [819.0 B]
- demo_dataloader.py [506.0 B]
- demo_vector.py [818.0 B]
- demo_text_split.py [661.0 B]
- pku.txt [4.2 KB]
- demo_retriver.py [940.0 B]
inspectionProfiles6 条
- profiles_settings.xml [174.0 B]
- Agent_Email_Generate.iml [317.0 B]
- modules.xml [299.0 B]
- workspace.xml [6.2 KB]
- misc.xml [268.0 B]
- .gitignore [184.0 B]
__pycache__9 条
- __init__.cpython-310.pyc [170.0 B]
- custom_tools.cpython-310.pyc [2.0 KB]
- custom_tools.cpython-312.pyc [2.8 KB]
- __init__.cpython-312.pyc [244.0 B]
- custom_tools.py [2.9 KB]
- __init__(1).py
- __init__.py
- __init__.py
- main.py [4.2 KB]
- email_category.txt [943.0 B]
- poie.txt [35.0 B]
- test.py [124.0 B]
01-讲义3 条
- 01-LLM基础知识.pdf [1.2 MB]
- 02-Assistant API的原理及应用.pdf [579.6 KB]
- 01-GPTs的介绍及应用.pdf [727.2 KB]
inspectionProfiles8 条
- profiles_settings.xml [174.0 B]
- MiniMax_Assistant.iml [291.0 B]
- .gitignore [184.0 B]
- misc.xml [310.0 B]
- modules.xml [293.0 B]
- workspace.xml [5.1 KB]
- fruit_price.txt [250.0 B]
- minmax_assistant.py [5.3 KB]
02-讲义1 条
- 基于GPT2搭建医疗问诊机器人.pdf [612.9 KB]
min_ppl_model_bj3 条
- config.json [977.0 B]
- generation_config.json [119.0 B]
- model.safetensors [366.5 MB]
epoch972 条
- pytorch_model.bin [378.5 MB]
- config.json [838.0 B]
config1 条
- config.json [875.0 B]
templates2 条
- index.html [694.0 B]
- index1.html [1.9 KB]
other_data2 条
- 闲聊语料.txt [65.0 MB]
- 闲聊语料.pkl [68.8 MB]
data4 条
- medical_valid.pkl [134.3 KB]
- medical_train.pkl [9.8 MB]
- medical_valid.txt [130.8 KB]
- medical_train.txt [9.5 MB]
gpt24 条
- vocab.json [1017.9 KB]
- generation_config.json [130.0 B]
- tokenizer.json [1.3 MB]
- merges.txt [494.5 KB]
data_preprocess4 条
- preprocess.py [3.9 KB]
- __init__.py [70.0 B]
- dataset.py [2.1 KB]
- dataloader.py [4.4 KB]
vocab10 条
- vocab.txt [74.3 KB]
- vocab2.txt [127.6 KB]
- flask_predict.py [2.6 KB]
- functions_tools.py [3.3 KB]
- train.py [11.4 KB]
- parameter_config.py [2.6 KB]
- app.py [487.0 B]
- __init__.py [72.0 B]
- interact.py [5.5 KB]
- readme [1.9 KB]
01-讲义(1)2 条
- SQL.pdf [29.0 KB]
- 01-Function Call的原理及应用.pdf [797.7 KB]
__pycache__1 条
- … 其余 1168 项略,目录共 1368 项
同类课程
和你正在看的这门一个方向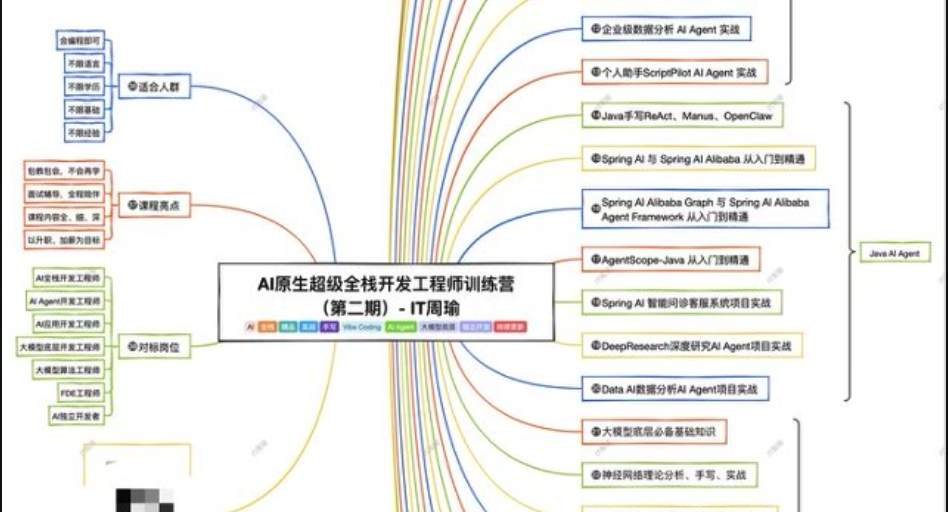 AI 查看详情
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI 查看详情
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI 查看详情
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货