 人工精选
聚客大模型第四期
大模型应用落地的工程化拼图 这门课的核心价值在于填补了“会用大模型 API”与“能独立交付企业级 AI 产品”之间的能力缺口。当前职场中,单纯调用接口已无法满足业务需求,真正的门槛在于私有数据的检索增强(RAG)、模型的垂直领域微调以及多智能体的协同工作流。课程通过 HuggingFace 生态、L
会员可免费下载本篇月会员可免费领取。
开通会员 ›会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
大模型应用落地的工程化拼图
这门课的核心价值在于填补了“会用大模型 API”与“能独立交付企业级 AI 产品”之间的能力缺口。当前职场中,单纯调用接口已无法满足业务需求,真正的门槛在于私有数据的检索增强(RAG)、模型的垂直领域微调以及多智能体的协同工作流。课程通过 HuggingFace 生态、LangChain/LlamaIndex 框架以及 Llama-Factory 工具链,系统性地拆解了从数据预处理到最终部署的完整链路。它解决的不是单一的技术点,而是如何构建一个具备可解释性、可控性和落地能力的智能系统,特别适合希望从调参侠转型为 AI 应用工程师的开发者。
分层学习路径与适用基础建议
本课程适合具备 Python 基础、了解深度学习基本概念(如 Transformer 架构)的学习者。若你完全零基础,建议先补充 PyTorch 基础;若已有 API 调用经验,可直接切入进阶模块。资料体系庞大,建议按以下优先级展开:
首先务必夯实地基,优先观看 **HuggingFace 核心组件** 与 **BERT 情感分析** 章节。这是理解现代 NLP 模型运作逻辑的关键,Bert 的训练篇能让你直观掌握预训练与微调的本质区别,避免后续学习陷入黑盒迷信。
其次,集中突破 **RAG(检索增强生成)** 技术栈。这是目前企业落地最主流的方案。请依次学习 **LlamaIndex 快速构建 RAG**、**进阶 Embedding 与向量库操作**、**文档切分与重排序优化**,最后通过 **Dify** 和 **RAGFlow** 两个低代码/平台化工具验证成果。这一组模块构成了处理企业私有知识库的标准作业程序,是面试和项目实战的高频考点。
再次,深入 **模型微调与压缩**。利用 **Llama-Factory** 完成 Qwen 模型的定制化微调及自定义数据集构建,并结合 **知识蒸馏** 与 **分布式推理部署** 章节,理解如何在算力受限场景下平衡性能与成本。这部分内容直接对应高阶算法岗位的核心竞争力。
最后,拓展视野至 **多智能体协作** 与 **多模态应用**。通过 LangGraph 构建复杂的多 Agent 工作流,是解决单一模型无法应对长链条任务的终极方案;多模态章节则展示了图文混排的边界扩展。
资料配合与实战产出
资料包中的代码项目并非孤立存在,而是层层递进的工程样本。在学习 RAG 相关模块时,务必配合源码复现文档切分策略的差异,这是提升检索准确率的细节关键。在微调环节,重点研读 Llama-Factory 的配置逻辑,而非仅仅运行脚本,因为只有理解参数背后的原理,才能应对实际业务中的冷启动问题。
学完本系列后,你将能够独立设计并实现一套完整的 RAG 知识库问答系统,掌握针对特定行业(如法律条文解析)的数据清洗与微调技巧,并具备使用 LangGraph 编排多步骤自动化任务的能力。这不仅是技能的叠加,更是工程思维的闭环,足以支撑你在 AI 应用开发领域建立实质性的职业壁垒。
课程目录
13-大模型推理部署(分布式推理与量化部署)1 条
- day13_大模型推理部署(分布式推理与量化部署)【耗时整理‖免费分享 】.zip [4.0 MB]
23-基于RAG的法律条文智能助手-实现与部署2 集
- day23_基于RAG的法律条文智能助手-实现与部署【耗时整理‖免费分享 】.zip [1.3 MB]
- day23【耗时整理‖免费分享 】.mp4 [1.8 GB]
02-基于Bert的中文评价情感分析(训练篇)2 集
- 基于Bert的中文评价情感分析【耗时整理‖免费分享 】.mp4 [626.9 MB]
- day02_基于Bert的中文评价情感分析(训练篇)【耗时整理‖免费分享 】.zip [371.0 MB]
18-Llama_indexRAG进阶_Embedding_model与Chroma2 集
- day18_Llama_indexRAG进阶_Embedding_model与ChromaDB【耗时整理‖免费分享 】.zip [1.4 MB]
- day18【耗时整理‖免费分享 】.mp4 [884.5 MB]
26-LangGraph构建多智能体2 集
- day26_LangGraph构建多智能体【耗时整理‖免费分享 】.zip [512.5 KB]
- day26【耗时整理‖免费分享 】.mp4 [1.1 GB]
28-多模态大模型应用2 集
- day28_多模态大模型应用【耗时整理‖免费分享 】.zip [5.8 MB]
- day28【耗时整理‖免费分享 】.mp4 [1.2 GB]
01-HuggingFace核心组件介绍2 集
- 01-HuggingFace核心组件介绍【耗时整理‖免费分享 】.mp4 [802.6 MB]
- day01_HuggingFace核心组件介绍【耗时整理‖免费分享 】.zip [1.1 GB]
17-Llamaindex快速构建RAG1 集
- day17【耗时整理‖免费分享 】.mp4 [1.5 GB]
19-Llama_indexRAG进阶_文档切分与重排序2 集
- day19【耗时整理‖免费分享 】.mp4 [1.3 GB]
- day19_Llama_indexRAG进阶_文档切分与重排序【耗时整理‖免费分享 】.zip [817.6 KB]
21-RAGFlow2 集
- day21_RAGFlow【耗时整理‖免费分享 】.zip [3.4 MB]
- day21【耗时整理‖免费分享 】.mp4 [1.0 GB]
14-大模型评估测试(OpenCompass)2 集
- day14【耗时整理‖免费分享 】.mp4 [1.4 GB]
- day14_大模型评估测试(OpenCompass)【耗时整理‖免费分享 】.zip [453.2 KB]
12-大模型压缩训练(知识蒸馏)1 条
- day12_大模型压缩训练(知识蒸馏)【耗时整理‖免费分享 】.zip [927.4 KB]
04-GPT2-中文生成模型定制化(训练篇)1 集
- GPT2-中文生成模型定制化_训练篇【耗时整理‖免费分享 】.mp4 [625.7 MB]
08-大模型微调(LLama Factory自定义微调数据集)1 条
- day08_大模型微调(LLama Factory自定义微调数据集)【耗时整理‖免费分享 】.zip [1.0 MB]
20-Dify实现RAG2 集
- day20_Dify实现RAG【耗时整理‖免费分享 】.zip [2.5 MB]
- day20【耗时整理‖免费分享 】.mp4 [768.5 MB]
25-Dify构建Agent2 集
- day25【耗时整理‖免费分享 】.mp4 [872.8 MB]
- 【课件】Agent 智能体应用(Dify构建Agent)【耗时整理‖免费分享 】.zip [4.1 MB]
.idea1 条
- workspace【耗时整理‖免费分享 】.xml [2.0 KB]
1_Pooling1 条
- config【耗时整理‖免费分享 】.json [305.0 B]
2_Normalize11 条
- config_sentence_transformers【耗时整理‖免费分享 】.json [214.0 B]
- added_tokens【耗时整理‖免费分享 】.json [24.0 B]
- model【耗时整理‖免费分享 】.safetensors [449.9 MB]
- tokenizer【耗时整理‖免费分享 】.json [799.1 KB]
- README【耗时整理‖免费分享 】.md [3.8 KB]
- config【耗时整理‖免费分享 】.json [775.0 B]
- special_tokens_map【耗时整理‖免费分享 】.json [732.0 B]
- sentence_bert_config【耗时整理‖免费分享 】.json [57.0 B]
- modules【耗时整理‖免费分享 】.json [368.0 B]
- vocab【耗时整理‖免费分享 】.txt [182.4 KB]
- tokenizer_config【耗时整理‖免费分享 】.json [1.5 KB]
1_Pooling22 条
- config【耗时整理‖免费分享 】.json [190.0 B]
- 【耗时整理‖免费分享 】.mdl [62.0 B]
- 【耗时整理‖免费分享 】.msc [956.0 B]
- config【耗时整理‖免费分享 】.json [687.0 B]
- model【耗时整理‖免费分享 】.safetensors [450.0 MB]
- vocab【耗时整理‖免费分享 】.txt [182.4 KB]
- 【耗时整理‖免费分享 】.mv [36.0 B]
- eval_results【耗时整理‖免费分享 】.txt [69.0 B]
- README【耗时整理‖免费分享 】.md [10.1 KB]
- training_progress_scores【耗时整理‖免费分享 】.csv [422.0 B]
- special_tokens_map【耗时整理‖免费分享 】.json [125.0 B]
- configuration【耗时整理‖免费分享 】.json [52.0 B]
- tokenizer【耗时整理‖免费分享 】.json [799.1 KB]
- sentence_bert_config【耗时整理‖免费分享 】.json [53.0 B]
- modules【耗时整理‖免费分享 】.json [229.0 B]
- tokenizer_config【耗时整理‖免费分享 】.json [394.0 B]
- download【耗时整理‖免费分享 】.py [185.0 B]
- get_data【耗时整理‖免费分享 】.py [6.9 KB]
- cleaned_output【耗时整理‖免费分享 】.txt [53.1 KB]
- model_convert【耗时整理‖免费分享 】.py [903.0 B]
- data_convert【耗时整理‖免费分享 】.py [762.0 B]
- day16_大模型微调项目实战(情绪对话模型-最终效果)【耗时整理‖免费分享 】.zip [839.1 MB]
06-本地私有化部署大模型(Ollama&vLLM&LMDeploy2 集
- 本地私有化部署大模型【耗时整理‖免费分享 】.mp4 [1.1 GB]
- day06_本地私有化部署大模型【耗时整理‖免费分享 】.zip [453.6 KB]
001开班典礼2 集
- 【聚客AI】AI大模型应用技术2025 - V1.0(1)【耗时整理‖免费分享 】.pdf [208.6 KB]
- 00-开班典礼【耗时整理‖免费分享 】.mp4 [468.5 MB]
10-大模型微调(LLamaFactory微调效果与vllm部署效果不一致如何解决)2 集
- day10_大模型微调(LLamaFactory微调效果与vllm部署效果不一致如何解决)【耗时整理‖免费分享 】.zip [630.4 KB]
- day_10视频【耗时整理‖免费分享 】.mp4 [1.3 GB]
11-大模型微调分布式训练(LLama Factory与Xtuner分布式微调大模型)2 集
- day11【耗时整理‖免费分享 】.mp4 [1.3 GB]
- day11_大模型微调分布式训练(LLama Factory与Xtuner分布式微调大模型)【耗时整理‖免费分享 】.zip [1.1 MB]
24-基于RAG的法律条文智能助手-微调与部署2 集
- day24【耗时整理‖免费分享 】.mp4 [1.2 GB]
- day24_基于RAG的法律条文智能助手-微调与部署【耗时整理‖免费分享 】.zip [1.2 MB]
22-基于RAG的法律条文智能助手(方案篇)2 集
- day22【耗时整理‖免费分享 】.mp4 [1.2 GB]
- day22_基于RAG的法律条文智能助手(方案篇)【耗时整理‖免费分享 】.zip [742.1 KB]
09-大模型微调(QLora微调&GGUF模型转换)2 集
- day09_大模型微调(QLora微调&GGUF模型转换)【耗时整理‖免费分享 】.zip [1.1 MB]
- 视频【耗时整理‖免费分享 】.mp4 [1.2 GB]
03-基于Bert的中文评价情感分析(实现篇)1 集
- _基于Bert的中文评价情感分析-实现【耗时整理‖免费分享 】.mp4 [522.1 MB]
27-DeepSeek原理与应用2 集
- day27_DeepSeek原理与应用【耗时整理‖免费分享 】.zip [1.0 MB]
- day27【耗时整理‖免费分享 】.mp4 [1.1 GB]
同类课程
和你正在看的这门一个方向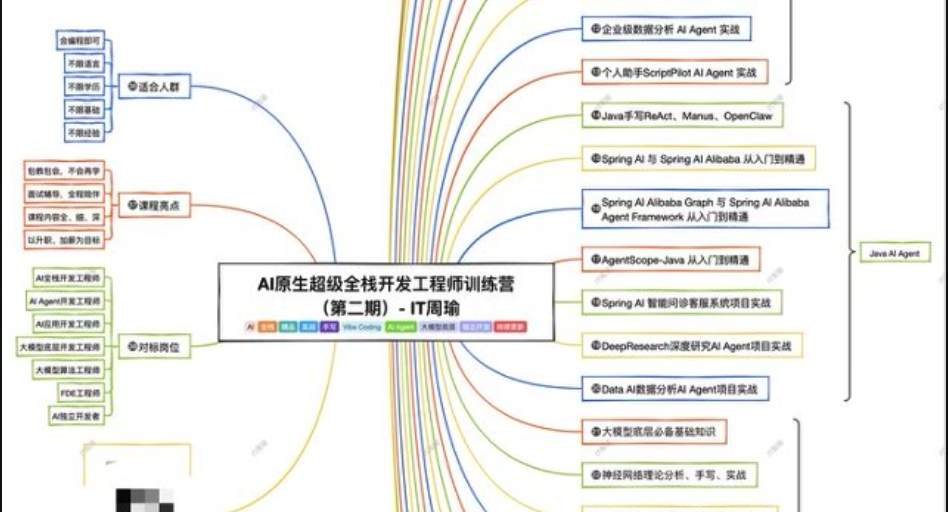 AI 查看详情
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI 查看详情
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI 查看详情
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货