 人工精选
【极客时间】AI 赋能 Python 开发实战课【已完结】(新课首发,)
这门课解决什么工作场景 当前很多开发者面临两个痛点:一是写 Python 代码时重复劳动多,尤其是数据清洗、类型定义、异常处理这类繁琐环节;二是想要落地 AI 应用,但不知道如何把 LLM 能力集成到现有工程中。这门课正是针对这两个问题设计的。它不教你从零学习 Python 语法,而是假设你已经具备
会员可免费下载本篇月会员可免费领取。
开通会员 ›会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
这门课解决什么工作场景
当前很多开发者面临两个痛点:一是写 Python 代码时重复劳动多,尤其是数据清洗、类型定义、异常处理这类繁琐环节;二是想要落地 AI 应用,但不知道如何把 LLM 能力集成到现有工程中。这门课正是针对这两个问题设计的。它不教你从零学习 Python 语法,而是假设你已经具备基础编程能力,重点讲解如何利用 Cursor、Dify、LlamaIndex 等工具链,提升开发效率并构建智能应用。
课程围绕实际工作流展开,比如借助大语言模型进行非结构化数据的半结构化整理、使用 ReAct 框架实现 Agentic 反思机制、通过 RAG 技术优化知识检索回答质量。你不需要关心底层模型原理,只需要掌握在业务场景中正确调用和组合这些 AI 能力的技巧。对于想在简历上增加“AI 工程化落地”经验的转行者,或者希望团队内部推广 AI 辅助开发的职场人,这是一个务实的选择。
适合什么基础以及核心内容分布
本课程适合已经熟悉 Python 基本语法、有实际项目经验的中级开发者。如果你还在为 `def` 和 `class` 发愁,建议先补齐基础。课程前置要求包括了解 Git 操作、能独立部署 Docker 容器、理解 HTTP 接口基本概念。资料包中的视频时长从 58MB 到 150MB 不等,整体偏向实战演示而非理论推导。
全课程内容可分为三个板块:基础强化与工具配置、RAG 与 Agent 核心架构、企业级应用封装。前两个章节集中在 Python 高阶特性(如装饰器、魔术方法)和 Cursor IDE 的配置,这是为了让你在后续使用 LLM 辅助编码时有更规范的代码习惯。中间部分是核心,涵盖了 LlamaIndex 的多文件加载、模型替换、Web 框架封装,以及 Dify 的可视化编排和 MCP 协议的数据孤岛解决方案。最后部分涉及生产环境所需的部署监控、SSE 流式交互实现和自动化 CI/CD 生成。
值得注意的是,课程中多次出现 DeepSeek-R1 与普通大模型的对比分析,这意味着你需要关注国内主流开源模型的适配方式,而不仅仅是 OpenAI 系列。这种本土化的视角对在国内互联网环境工作的开发者尤为实用。
学完能独立做什么及学习建议
完成本课程后,你应该能够独立完成以下任务:第一,利用 Cursor 结合自定义模型编写符合 Pythonic 风格的生产级代码,并自动生成单元测试和注释;第二,基于 LlamaIndex 搭建支持多种文档格式的私有知识库检索系统,并能针对检索效果进行策略优化和评估;第三,使用 Dify 快速原型化一个带意图识别的智能对话应用,并通过 Gradio 或 Web 框架对外提供 API 服务;第四,理解并实现基于 MCP 协议的标准化工具调用接口,解决不同 AI 模块间的数据互通问题。
建议的学习顺序如下:先看环境搭建和 Cursor 配置部分,确保本地工具有序运行;接着深入理解 RAG 的基本工作过程和 LlamaIndex 的设计模式,这是后续所有进阶操作的基石;然后动手实践 Dify 的安装与扩展编写,感受低代码平台的灵活性;最后关注 MCM 协议和监控系统部分,完善对完整软件生命周期的认知。资料包中包含了具体的配置文件示例和代码片段,学习时应边看视频边在自己的环境中复现,特别是涉及 Docker 部署和模型调用的环节,切勿只看不动手。
课程目录
课程目录58 条
- 01|Python开发环境搭建.ts [150.9 MB]
- 32|借助大语言模型进行数据清洗.ts [130.6 MB]
- 42|使用Cursor为Dify编写扩展和测试.ts [145.4 MB]
- 08|借助LLM读代码.ts [144.9 MB]
- 45|掌握MCP协议的核心架构与标准化接口设计,解决数据孤岛.ts [141.4 MB]
- 29|LlamaIndex如何实现多文件类型加载.ts [127.9 MB]
- 38|使用ReAct框架实现Agentic反思的方法.ts [117.1 MB]
- 22|为LlamaIndex替换大模型.ts [100.9 MB]
- 24|使用Web框架封装和拆分LlamaIndex模块.ts [100.5 MB]
- 36|RAG的技术优化策略和业务优化策略.ts [99.6 MB]
- 41|Dify的安装和文档.ts [95.4 MB]
- 13|开源大模型中的装饰器典型用法.ts [92.2 MB]
- 14|classmethod与staticmethod.ts [91.5 MB]
- 26|使用LLM设计和理解异常处理.ts [90.0 MB]
- 39|利用Gradio构建网页Demo.ts [88.1 MB]
- 25|契约式设计与防御式编程.ts [87.1 MB]
- 34|封装Llamaindex并测试.ts [85.3 MB]
- 31|借助大语言模型将非结构化数据整理为半结构化数据.ts [85.2 MB]
- 52|DeepSeek-R1有效提升编程效率的三种形式.ts [84.6 MB]
- 20|RAG的概念和基本工作过程.ts [84.3 MB]
- 05|Python的鸭子类型与魔术方法.ts [84.0 MB]
- 15|名称改写、猴子补丁与抽象基类.ts [80.6 MB]
- 51|DeepSeek-R1与普通大模型在软件开发领域的差异.ts [76.3 MB]
- 02|Cursor的配置与快捷键(上).ts [74.0 MB]
- 06|借助LLM练习魔术方法.ts [73.7 MB]
- 19|利用大语言模型深入分析LlamaIndex设计模式的三种方法.ts [73.5 MB]
- 10|定义函数与校验函数.ts [73.0 MB]
- 18|SOLID与设计模式.ts [72.0 MB]
- 35|利用提示词工程完成意图识别.ts [71.7 MB]
- 40|SSE原理与流式交互的实现.ts [70.1 MB]
- 21|llamaindex使用OpenAI协议模型.ts [68.8 MB]
- 17|Mixin.ts [68.9 MB]
- 11|匿名函数与柯里化.ts [66.2 MB]
- 47|基于Python快速构建带安全认证的MCP服务端与客户端.ts [65.8 MB]
- 43|借助Claude自动创建Docker必备的配置文件.ts [64.4 MB]
- 44|通过Prometheus实现健康监控及自动创建CICD通用框架.ts [62.9 MB]
- 28|利用LLM解释异常.ts [61.6 MB]
- 09|借助LLM生成Python风格的数据类型.ts [63.7 MB]
- 37|RAG的评估方法和策略.ts [60.8 MB]
- 04|为Cursor更换自定义模型并实现代码注释的生成.ts [58.5 MB]
- 23|自定义LlamaIndex功能与统一接口.ts [57.0 MB]
- 12|装饰器的作用域.ts [50.8 MB]
- 07|数据类型和数据结构间的自动转换.ts [50.3 MB]
- 27|利用LLM生成日志可视化和异常分析.ts [49.3 MB]
- 49|构建基于MCP协议的AI爬虫系统,零编码动态采集网页数据.ts [40.4 MB]
- 48|轻量级MCP工具开发,代码级实践.ts [39.8 MB]
- 53|使用DeepSeek-R1实现大模型的多轮对话与意图识别.ts [38.8 MB]
- 03|Cursor的配置与快捷键(下).ts [34.7 MB]
- 30|如何借助大模型生成OCR功能的代码.ts [33.8 MB]
- 16|类型注解.ts [33.2 MB]
- 33|借助大语言模型优化数据可视化.ts [32.7 MB]
- 57|DeepSeek-R1与办公软件等集成.ts [31.7 MB]
- 46|通过MCP协议实现AIAgent的动态工具调用与上下文同步.ts [31.4 MB]
- 55|基于DeepSeek-R1构建RAG系统,提升信息检索精度.ts [22.0 MB]
- 50|模块介绍.ts [12.2 MB]
- 54|通过联网搜索和外部工具增强DeepSeek-R1的时效性.ts [10.1 MB]
- 56|探索DeepSeek-R1与RPA技术的结合点,促进跨系统操作自动化.ts [4.6 MB]
- 58|模块小结.ts [8.6 MB]
同类课程
和你正在看的这门一个方向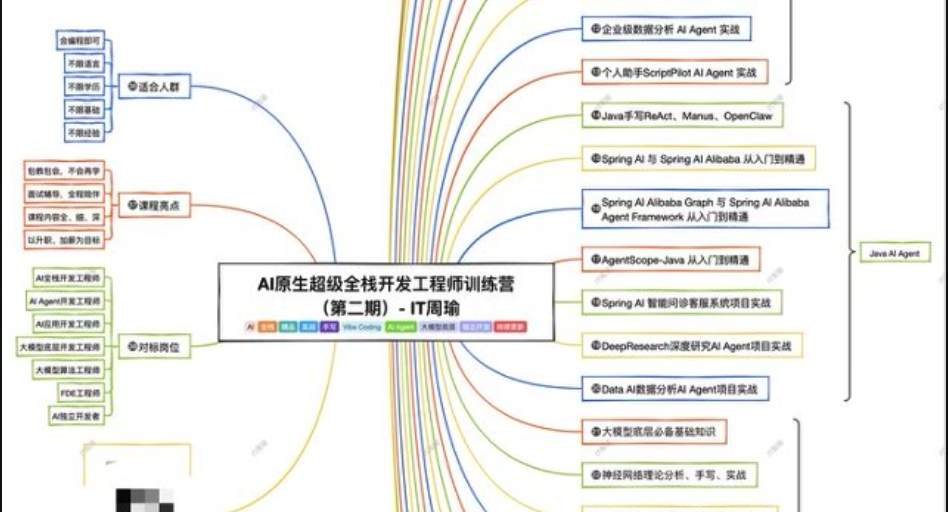 AI 查看详情
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI 查看详情
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI 查看详情
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货