 人工精选
自进化 Agent 工程实战
Agent 跑飞了?先学会给它装“刹车”和“记忆” 很多团队在落地 Agent 时,最常遇到的尴尬是:单轮任务跑得挺顺,一旦涉及多步执行或长对话,模型就开始“幻觉”、忘记初衷,甚至无限循环调用工具。这门课没有一上来就讲如何写 Prompt,而是把重点放在了工程化的“Harness”概念上,即如何为
会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
Agent 跑飞了?先学会给它装“刹车”和“记忆”
很多团队在落地 Agent 时,最常遇到的尴尬是:单轮任务跑得挺顺,一旦涉及多步执行或长对话,模型就开始“幻觉”、忘记初衷,甚至无限循环调用工具。这门课没有一上来就讲如何写 Prompt,而是把重点放在了工程化的“Harness”概念上,即如何为 Agent 搭建一个可控的执行外壳,确保每一轮交互都在既定轨道上运行。
它主要解决的是从“独立作业”到“经验成长”的跨越问题。如果你是开发者或 AI 产品经理,需要理解如何让 Agent 不再是一锤子买卖,而是能通过上下文管理、规则约束和会话分支,在复杂的企业场景中稳定运行并积累历史经验,这门课的实战思路非常对口,直接切中当前 Agent 落地最痛的稳定性问题。
学习路径:从执行引擎到长程记忆
课程适合具备基础编程能力、对 LLM 调用有一定了解的读者。门槛不高,但需要你能看懂代码逻辑,理解基本的 API 调用流程。建议的学习路径是从“执行引擎”切入,先搞清楚用户的一句话是如何被拆解并转化为连续的工具调用动作的。这是理解后续所有高级特性的地基,跳过这一步直接看长程运行会非常吃力。
紧接着,重点攻克“上下文引擎”与“AGENTS.md”的设计。很多初学者忽视的是,模型每轮对话到底“看见”了什么?如何通过设计规则文件,在底层约束 Agent 的未来行为,而不是仅靠表面 prompt 喊话?这部分内容是保证 Agent 不“跑偏”的关键。最后,再进阶到“长程运行”中的上下文压缩与会话分支技巧,学习如何在不丢失关键信息的前提下,让 Agent 能够基于旧经历开启新的调查任务,实现真正的自进化。
学完产出与资料配合用法
完成学习后,你将能够独立设计并部署具备长期记忆和行为约束的 Agent 应用。你不再是被动地等待模型输出,而是懂得通过工程手段干预执行流程,解决 Agent 在真实工作流中的稳定性问题,能够输出可落地的工程方案而非玩具级 Demo。
课程配套的实战资料非常适合边看边练。建议读者不要只看不敲代码,重点尝试修改 AGENTS.md 中的规则,观察 Agent 行为的变化;并动手实践上下文压缩的逻辑,体验如何在资源有限的情况下保留核心记忆。这种“改规则-看反馈-调压缩”的循环练习,是掌握自进化 Agent 工程的最短路径,也能帮你快速建立对复杂 Agent 系统的直觉判断力。
课程目录
开篇词 (2讲)
- 开篇词|从看懂 Harness,到塑造会学习的数字分身
- 直播回放|从独立作业到经验成长:企业 Agent Harness 落地指南
初识 Harness (5讲)
- 01|Agent 执行引擎:一句话怎样变成连续行动?
- 01|Agent 执行引擎:一句话怎样变成连续行动_
- 02|一封迟到的信:怎样改变一个正在工作的 Agent?
- 03|上下文引擎:模型每轮对话都会看见什么?
- 04|AGENTS.md:如何设计规则指导 Agent 未来行动
长程运行 (3讲)
- 04|AGENTS.md:如何设计规则指导 Agent 未来行动
- 05|上下文压缩:如何压缩历史才不影响任务延续?
- 06|会话分支:怎样借助旧经历,开始一场新的调查?
同类课程
和你正在看的这门一个方向 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI 查看详情
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI 查看详情
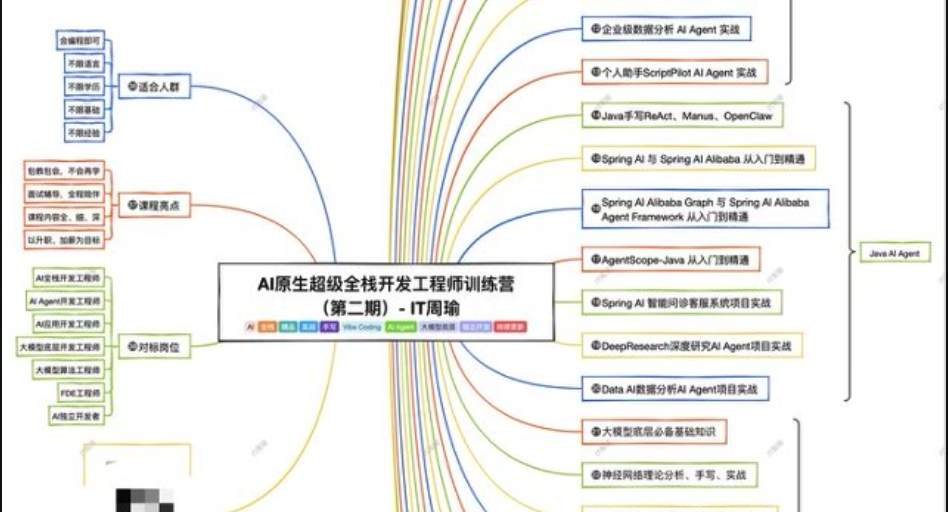
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI 查看详情
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货