 人工精选
深入拆解数字化智能文档处理
这门课解决什么工作场景 数字化智能文档处理的核心痛点,在于让机器精准读懂非结构化数据的“形”与“意”。传统 OCR 技术只能输出纯文本,一旦遇到复杂排版、嵌套表格或嵌入式图表便往往失效;而通用大模型虽擅长语义理解,却缺乏对文档版面结构的细粒度感知,容易产生幻觉。本课程正是为了解决这一断层,聚焦于从纸
会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
这门课解决什么工作场景
数字化智能文档处理的核心痛点,在于让机器精准读懂非结构化数据的“形”与“意”。传统 OCR 技术只能输出纯文本,一旦遇到复杂排版、嵌套表格或嵌入式图表便往往失效;而通用大模型虽擅长语义理解,却缺乏对文档版面结构的细粒度感知,容易产生幻觉。本课程正是为了解决这一断层,聚焦于从纸质扫描或 PDF 到高质量结构化数据的自动化转化。无论是财务场景中发票信息的批量录入与校验、法务合同中关键条款与风险点的自动提取,还是研报中复杂图表数据的还原,都属于其典型的应用场景。课程深入剖析了 pipeline 式方案与 end-to-end 式方案的技术差异,帮助读者在实际业务中根据准确率要求与成本预算做出合理选型,建立对文档智能全链路的系统性认知。
适合什么基础与学习建议
本课程适合具备一定 Python 编程基础、熟悉深度学习基本概念,并希望向多模态应用领域深耕的开发者、算法工程师或技术型产品经理。对于完全零基础的用户,若直接跳入模型细节可能会感到晦涩,因此建议遵循循序渐进的学习路径。入门阶段,务必精读前四节,重点建立对文档处理全流程的理解,包括数据集的构建逻辑与清洗规范,这是后续所有技术讨论的基石。在掌握基础后,可根据职业方向选择侧重点:若致力于解决企业内复杂的表格数据提取难题,应优先研读第 7 至第 8 节,深入理解面向大模型的表格表示方案及其落地陷阱;若关注前沿的多模态大模型技术,则可并行学习第 9 至第 12 节,对比 Visual-ChatGLM、MiniGPT-4、BLIP-2 及 Qwen-VL 等代表性项目在文档理解能力上的边界与伦理局限。最后,务必结合第 13 节的开源实操案例进行动手复现,将理论知识转化为可运行的代码,切忌纸上谈兵。
学完能独立做什么
完成课程学习后,读者应具备独立设计与实现轻量级文档智能处理系统的能力。具体而言,能够根据不同业务场景的需求,灵活选择合适的数据集格式进行微调或设计提示工程,以优化模型输出;能够客观评估多模态大模型在特定文档场景(如复杂长表格、图文混排页面)下的实际表现,识别并规避其常见的格式错误或内容幻觉;能够基于现有的开源项目,针对特定场景进行二次开发与改进,打通从原始文档输入到结构化数据输出的端到端任务。此外,课程还引导读者深入思考大模型落地时的实际约束条件,如推理延迟、计算成本、准确率与速度的权衡,从而在项目选型与技术架构设计上做出更务实、更具性价比的决策,避免陷入盲目追逐最新模型的误区。
课程目录
未分组
- 01|智能文档处理基本认知及处理流程
- 02|智能文档处理 pipeline 式方案及数据集
- 03|智能文档处理 end2end 式方案及数据集
- 04|文档图表理解能够做的一些事儿
- 05|大模型进行文档图表理解的代表项目
- 06|多模态大模型到底理不理解文档图表
- 07|大模型落地表格场景常见应用场景
- 08|面向大模型处理的表格表示方案
- 09|多模态大模型之 Visual-ChatGLM 及 MiniGPT4 系列
- 10|多模态大模型之 Blip-2 图文模型
- 11|多模态大模型之 CLIP 及 Qwen-VL
- 12|文档智能的技术界定与核心环节
- 13|文档智能的可用开源项目与实操案例
- 14|文档智能与大模型结合的场景及方向
同类课程
和你正在看的这门一个方向 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI 查看详情
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI 查看详情
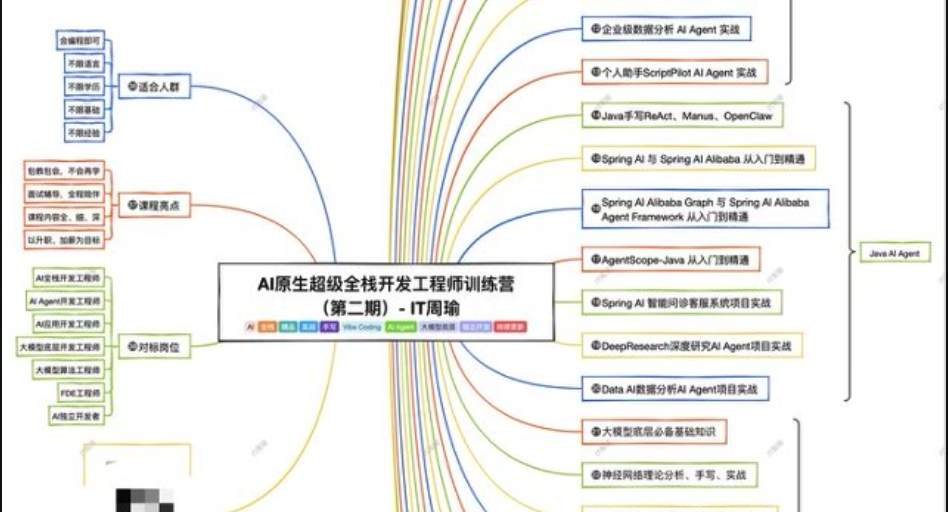
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI 查看详情
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货