 人工精选
强化学习快速入门与实战
# 强化学习快速入门与实战:从理论深渊到应用彼岸 在人工智能的版图中,强化学习(Reinforcement Learning, RL)常被戏称为“第三种范式”。如果说监督学习是从数据中寻找映射,生成式AI是从概率中重构世界,那么强化学习则是让智能体在与环境的博弈中学会生存。这门《强化学习快速入门与实
会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
# 强化学习快速入门与实战:从理论深渊到应用彼岸
在人工智能的版图中,强化学习(Reinforcement Learning, RL)常被戏称为“第三种范式”。如果说监督学习是从数据中寻找映射,生成式AI是从概率中重构世界,那么强化学习则是让智能体在与环境的博弈中学会生存。这门《强化学习快速入门与实战》课程,正是为你打通从经典算法原理到大模型前沿应用的全链路知识图谱。
一、 为何开启这段旅程?
许多学习者卡在强化学习的门槛上,并非因为缺乏编程能力,而是难以跨越从“马尔可夫决策过程(MDP)”到复杂策略优化的思维鸿沟。本课程开篇即带你游览“强化学习的游乐园”,旨在用直观的视角解构抽象概念。你不仅将理解智能体(Agent)、环境(Environment)、状态(State)、动作(Action)与奖励(Reward)的基本交互逻辑,更将掌握如何将这些元素形式化为可计算的数学模型。这是所有高级应用的基石。
二、 基础篇:构建扎实的认知框架
课程的基础部分(第1-5讲)并未急于堆砌代码,而是注重原理的深度溯源。你将首先厘清正统学习(On-policy)与异策学习(Off-policy)的本质区别,这是理解后续众多算法的关键钥匙。
在“基于价值”的学习中,我们将深入解析Q-learning与Deep Q-Network(DQN),揭示神经网络如何帮助智能体在高维空间中估算长期回报。而在“基于策略”的章节,你将接触策略梯度法(Policy Gradient)与Actor-Critic架构,理解为何在某些连续控制任务中,直接优化策略比估算价值更为有效。此外,第4讲关于动态规划与蒙特卡洛树搜索(MCTS)的内容,将展示在完美信息博弈(如AlphaGo早期版本)中,规划与搜索如何弥补模型缺失的不足。而“探索与利用”的权衡,则是强化学习永恒的痛点,多臂赌博机模型与汤普森采样将为你提供解决这一困境的利器。
三、 进阶篇:直面深度强化学习的核心挑战
进阶部分是本课程的精华所在,它直击当前AI研究的最前沿。从第6讲开始,我们将系统梳理从DQN到A3C的深度强化学习演进史,理解并行化训练如何加速收敛。
特别值得注意的是,课程并未止步于传统RL,而是敏锐地捕捉到了大语言模型(LLM)时代的变革。第8-10讲层层递进,从优势函数、泛化优势估计(GAE)到信任域策略优化(TRPO),详细剖析了如何通过自然梯度法约束策略更新幅度,防止性能崩溃。这一系列推导最终导向了目前最主流的PPO算法。而在第11讲,课程大胆地将视野拓展至LLM对齐领域,解读PPO在大规模预训练模型中的应用,并引入DPO(直接偏好优化)和GRPO等新兴范式。这意味着,学完本课程,你不仅能驾驭机器人控制、游戏AI等传统RL场景,更能介入当下最火热的LLM强化学习微调实战。
四、 学习建议
强化学习是一门“易学难精”的学科。建议你在阅读理论推导时,务必配合代码复现,亲手实现一个简易的CartPole平衡杆控制器或Atari游戏AI。只有在调试Reward Shape(奖励形状)的过程中,你才能真正体会“稀疏奖励”与“信用分配”的微妙之处。
这门课程不仅是一次技术扫盲,更是一把开启通用人工智能(AGI)大门的钥匙。无论你是希望从事游戏AI开发、机器人控制研究,还是探索大模型对齐的前沿算法,这里提供的知识体系都将为你奠定坚实的根基。让我们从第一个智能体开始,见证秩序从混沌中涌现。
课程目录
开篇词 (1讲)
- 开篇词|让我们带你游览强化学习的游乐园
基础篇 (5讲)
- 01|强化学习概述:从马尔可夫决策过程到智能体与环境交互
- 02|基于价值的强化学习:从Q-learning到Deep Q-Network
- 03|基于策略的强化学习:从策略梯度到Actor-Critic
- 04|模型与规划:从动态规划到蒙特卡洛树搜索
- 05|探索与利用:从多臂赌博机到汤普森采样
进阶篇 (13讲)
- 06|深度强化学习:从DQN到A3C
- 07|基础策略梯度法:Policy Gradient
- 08|优势函数:涵盖Actor Critic_GAE_TRPO
- 09|重要性采样:On-policy vs. Off-policy
- 10|TRPO精读:涵盖自然梯度法、全变分约束以及最终导向PPO
- 11|TRPO的大语言模型时代扩展:PPO、DPO、GRPO(上)
- 12|TRPO的大语言模型时代扩展:PPO、DPO、GRPO(下)
- 13|大语言模型时代的RL工作流:以RLHF为代表的后训练方法
- 14|强化学习前沿:从模仿学习到逆向强化学习
- 15|强化学习前沿:从离散控制到连续控制
- 16|强化学习前沿:离线强化学习
- 17|强化学习前沿:离线强化学习之BCQ
- 18|强化学习前沿:离线强化学习之CQL
应用篇 (13讲)
- 19|推荐系统:从个性化推荐到广告投放(上)
- 20|推荐系统:从个性化推荐到广告投放(下)
- 21|机器人控制:从机械臂到自动驾驶(上)
- 22|机器人控制:从机械臂到自动驾驶(中)
- 23|机器人控制:从机械臂到自动驾驶(下)
- 24|金融交易:从股票交易到投资组合优化(上)
- 25|金融交易:从股票交易到投资组合优化(下)
- 26|资源调度:从云计算到物流配送
- 27|自然语言处理:从机器翻译到对话系统(上)
- 28|自然语言处理:从机器翻译到对话系统(下)
- 29|计算机视觉:从目标检测到图像生成
- 30|强化学习平台与工具:从OpenAI Gym到Ray
- 31|强化学习未来展望:从通用人工智能到人机协作
结束语 & 结课测试 (2讲)
- 结束语|共赴强化学习的未来征程
- 结课测试|来赴一场满分之约!
同类课程
和你正在看的这门一个方向 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI 查看详情
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI 查看详情
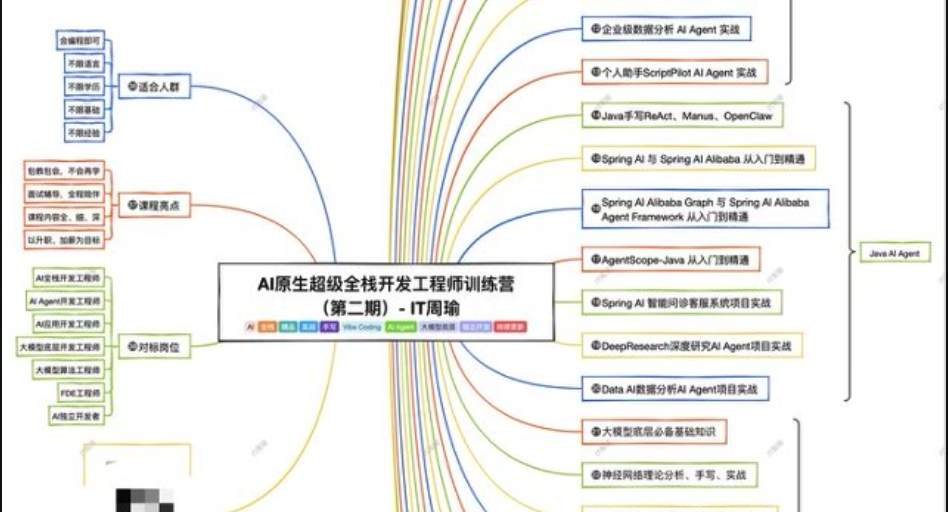
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI 查看详情
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货