 人工精选
RAG 与 Agent 性能调优 50 讲
这门课解决什么实际问题 RAG(检索增强生成)和 Agent(智能体)在落地时,最容易卡壳的不是大模型本身,而是“上下文注入”的质量。很多项目最终表现不佳,根源往往在于前端的数据预处理和检索策略没做好。本课程直击这一痛点:它不教你怎么写基础代码,而是专门针对多源文档解析、结构化切片、术语规范化以及混
会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
这门课解决什么实际问题
RAG(检索增强生成)和 Agent(智能体)在落地时,最容易卡壳的不是大模型本身,而是“上下文注入”的质量。很多项目最终表现不佳,根源往往在于前端的数据预处理和检索策略没做好。本课程直击这一痛点:它不教你怎么写基础代码,而是专门针对多源文档解析、结构化切片、术语规范化以及混合检索架构进行深度调优。
具体而言,课程解决了三大核心难题。首先是“脏数据”处理:面对 PDF、Word、图片混杂的文档,如何统一格式?跨页表格怎么自动对齐合并?OCR 识别错误如何结合 LLM 纠错?其次是“切片”科学:固定长度切片为何导致语义割裂?如何通过滑动窗口和关键词识别实现语义完整的段落切片?最后是“检索”效率:FAISS、HNSW 与 BM25 该如何选型?多阶段召回架构如何设计以提升覆盖率?这些是构建企业级知识库和智能问答系统时必须跨越的技术门槛。
适合什么基础,建议先看哪几块
本课程适合具备 Python 编程基础,且对 RAG/Agent 已有初步概念或实战经验的工程师、算法工程师及架构师。如果你从未接触过向量数据库或检索流程,建议先补齐 LangChain 或 LlamaIndex 的基础用法,再进入本课程的调优环节。课程难度中等偏上,侧重工程落地与性能优化,而非理论科普。
学习路径建议如下:优先攻克第 01~08 讲的“数据预处理流水线”。这是整个系统的基石,内容涵盖从文档解析、OCR 纠错、表格合并到语义切片的完整自动化流程。若跳过硬预处理直接看检索,后续效果难以保障。其次,重点研读第 09~10 讲的“检索引擎选型与混合架构”。这部分讲解如何根据业务场景选择向量库,以及如何设计召回策略提升准确率。对于 Agent 相关部分,可结合课程中关于工具调用和意图识别的内容进行针对性练习。
学完能独立做什么,资料如何配合练习
完成本课程后,你将能够独立设计和部署一个高性能、可落地的 RAG 或 Agent 系统。具体能力包括:构建一套自动化数据预处理管道,支持 PDF、Word、图片等多格式文档的高质量解析与清洗;掌握基于语义的文本切片技术,避免信息割裂导致的检索失效;能够根据业务需求选型向量数据库(如 FAISS、HNSW)并设计混合检索策略;最终实现一个准确率高、响应速度快的企业级知识库问答或智能助手原型。
资料包中包含详细的课程目录与实战案例,但无现成代码文件。建议学习者自行搭建开发环境,跟随课程思路复现每个技术点。例如,在处理跨页表格和 OCR 纠错时,可自行搜集真实业务文档进行测试;在对比不同向量引擎时,可搭建小规模基准测试集进行性能评估。通过“理论讲解 + 自主复现 + 参数调优”的方式,将知识转化为实际工程能力。
课程目录
未分组
- 01|如何统一多源文档格式?破解PDF、Word、图片等混杂内容解析难题
- 02|跨页表格怎么自动对齐合并?实现结构化输出的关键技术实战
- 03上|领域术语总混淆?构建精准术语词库,提升检索一致性
- 03下|领域术语总混淆?构建精准术语词库,提升检索一致性
- 04上|切片语义割裂怎么办?基于滑动窗口+关键词的语义段落识别
- 04下|切片语义割裂怎么办?基于滑动窗口+关键词的语义段落识别
- 05|固定切片召回率低?动态重叠切片机制显著提升覆盖率
- 06|OCR文本错漏频发?结合LLM纠错,让图像文本也能精准使用
- 07|图像切分不合理?文本图像矫正和版面区域检测保障信息完整且不冗余
- 08|打造可配置、可扩展的自动化预处理流水线
- 09|FAISS、HNSW还是BM25?如何选择最适合业务的向量检索引擎?
- 10|多阶段召回总不准?设计高效混合检索架构提升覆盖率与精度
- 11|HNSW参数调优难?掌握SQ8量化压缩技术,实现速度与准确率平衡
- 12|用户查询太模糊?用查询扩展提升语义匹配能力
- 13|稀疏查询召回差?HyDE伪文档生成技术解决冷启动问题
- 14|多路召回融合难?动态阈值机制确保高质量结果优先排序
- 15|政策文档检索总是漏关键点?构建高精度垂直领域检索系统
- 16|如何科学调节切片长度与滑动窗口?结合倒排索引与向量索引对比优化
- 17|模型忽略关键实体怎么办?注意力权重分配机制引导生成聚焦重点
- 18|生成内容出错?构建事实验证链+溯源标注方案有效抑制幻觉
- 19|资源有限还想微调大模型?掌握LoRA参数高效方法适配垂直领域
- 20|轻量级部署术语准确率低?Adapter网络微调实现低开销优化
- 21|提示词效果不稳定?上下文融合Prompt工程显著提升生成质量
- 22|多个模型不知选哪个?设计多模型路由机制智能选择最优生成器
- 23|长文本生成结构混乱?使用记忆网络与分段生成,确保长文内容逻辑清晰、结构完整
- 24|金融问答系统生成不准?端到端流程优化提升结果可靠性
- 25|Agentic RAG原理与多阶段任务分解机制详解
- 26|工具调用效率优化:基于Top Agent与Tool Agent的协同调度架构
- 27|如何让Agent智能选工具?Gumbel-Softmax决策算法实现自动选择
- 28|Agent记不住历史信息?Memory Transformer实现长期记忆建模
- 29|动态任务规划支持复杂推理与执行,实战构建合规审查系统
- 30|图文混合文档解析难?OCR+LLM三阶段提取与联合索引构建
- 31|文本与图像怎么一起检索?跨模态Embedding融合实现图文召回
- 32|自然语言怎么转SQL?Text2SQL生成与Schema自适应策略
- 33|如何用向量数据库搜索图像?基于Milvus的图像嵌入与相似性检索实践
- 34|CRAG自修正机制提升文档匹配精度与召回稳定性
- 35|多模态任务怎么做评估?详解跨模态检索与生成的质量评价方法
- 36|模型推理效率低?vLLM+量化技术加速模型推理
- 37|成本太高?基于请求热度的冷热模型分层部署策略
- 38|高频请求扛不住?多级缓存架构+Redis集群设计保障性能
- 39|服务扩容手动?Kubernetes弹性伸缩+负载均衡实现自动化运维
- 40|告别黑盒!用LangSmith打造大模型调用链追踪与观测工具
- 41|测试用例维护难?LangSmith自动化测试实现持续验证
- 42|多租户客服系统状态混乱?会话隔离与上下文跟踪机制实现精准响应
- 43|医疗诊断模型F1值低?构建高精度RAG系统提升糖尿病相关问答准确性
- 44|Dify联合RAGFlow:全面升级语义理解与动态召回能力
- 45|工具前沿:MCP连接智能与世界的“神经末梢”
- 46|工具前沿:智能体与RPA的组合,打造企业自动化新范式
- 47|工具前沿:Human-in-the-Loop在智能体系统中的关键作用与LangGraph实践
- 48|RAG设计范式驱动下的text2SQL实践
- 49|从被动响应到主动思考:Agentic RAG构建可自主决策的知识智能系统
- 50|技术点分布与架构汇总
- 开篇介绍
- 期中编程作业
- 结束语 & 结课测试
同类课程
和你正在看的这门一个方向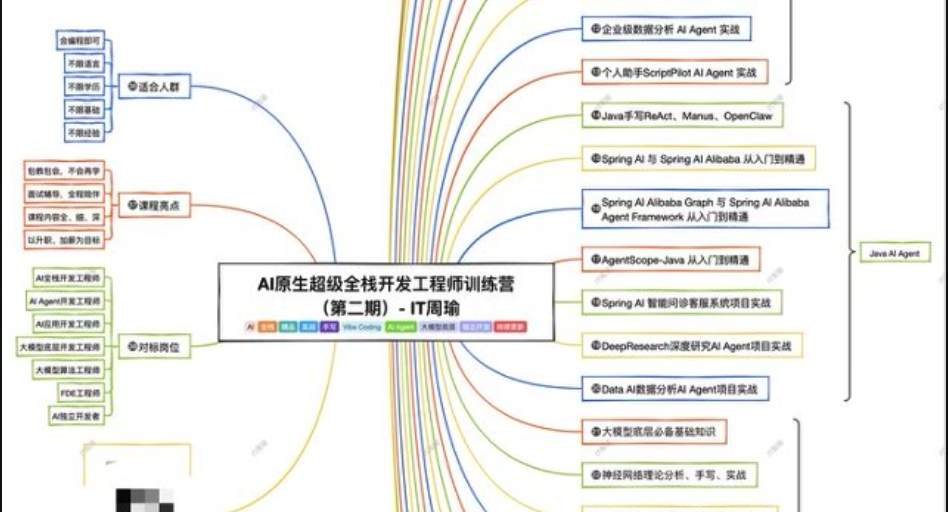 AI 查看详情
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI 查看详情
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI 查看详情
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货