 人工精选
NLP实战高手课
先判断:这门课解决什么实际痛点 NLP(自然语言处理)是AI商业化最成熟的赛道之一,但大量培训班只教调包或只讲数学推导,导致学员要么只会跑Demo无法落地,要么懂原理却写不出代码。本课程的核心价值在于“工程化思维”的构建。它并非孤立地讲解算法,而是从AI项目的全生命周期出发——从需求分析、模型选型、
会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
先判断:这门课解决什么实际痛点
NLP(自然语言处理)是AI商业化最成熟的赛道之一,但大量培训班只教调包或只讲数学推导,导致学员要么只会跑Demo无法落地,要么懂原理却写不出代码。本课程的核心价值在于“工程化思维”的构建。它并非孤立地讲解算法,而是从AI项目的全生命周期出发——从需求分析、模型选型、框架对比,一直讲到硬件适配与微服务部署。课程特别设置了智能问答系统和文本校对系统两个典型场景,覆盖NLP核心任务。对于希望在简历上体现完整项目经验、而非仅有概念认知的职场人来说,这套从实验到落地的闭环视角是稀缺的。
门槛与学习路径:别一上来就啃代码
本课程对编程基础有一定要求,建议至少熟悉Python语法和基本数据结构。如果你完全零基础,建议先补足基础再入场,否则在第16-18节关于统计学和神经网络的部分会非常吃力。
推荐的学习顺序如下:
第一阶段建立认知:重点阅读第05节(NLP领域简介)和第06-07节(应用案例)。这两部分是全课程的基石,帮你厘清“NLP能做什么”以及“不同任务的技术路线差异”。不要跳过,这是后续理解模型选择逻辑的前提。
第二阶段补齐基础:第16-18节涉及概率统计和神经网络原理。这部分看似枯燥,却是理解“随机性如何影响数据拟合”以及“模型为何这样训练”的关键。如果时间紧迫,可先通读大意,待后续实操中遇到瓶颈时再回溯。
第三阶段工程进阶:第09-15节涵盖深度学习框架、硬件(CPU/GPU/TPU)及部署原则。这部分适合有开发经验的读者,重点理解“为什么选这个框架”以及“模型上线时的架构考量”。
学完能独立做什么:资料配合练习建议
完成本课程后,你应具备以下独立能力:
一是方案选型能力。面对业务需求,能判断是否适合引入NLP,并选择合适的任务类型和技术栈,而非盲目套用模型。
二是原型搭建能力。能够基于现有框架,独立完成一个小型智能问答或文本校对系统的搭建,包括数据预处理、模型调用及结果评估。
三是部署意识。理解模型从实验环境到生产环境的关键步骤,知道何时需要GPU加速、如何进行简单的微服务封装。
建议配合资料的练习方式:不要只看视频或文档,务必动手复现课程中的问答系统和校对工具。重点关注数据流向——从原始文本输入到模型推理输出的全过程。遇到报错或效果不佳时,回溯到基础章节查找理论依据。只有将原理与代码结合,才能真正内化为可复用的技能。
课程目录
未分组
- 01 _ 课程介绍
- 02 _ 内容综述
- 03 _ AI概览:宣传片外的人工智能
- 04 _ AI项目流程:从实验到落地
- 05 _ NLP领域简介:NLP基本任务及研究方向
- 06 _ NLP应用:智能问答系统
- 07 _ NLP应用:文本校对系统
- 08 _ NLP的学习方法:如何在AI爆炸时代快速上手学习?
- 09 _ 深度学习框架简介:如何选择合适的深度学习框架?
- 10 _ 深度学习与硬件:CPU
- 11 _ 深度学习与硬件:GPU
- 12 _ 深度学习与硬件:TPU
- 13 _ AI项目部署:基本原则
- 14 _ AI项目部署:框架选择
- 15 _ AI项目部署:微服务简介
- 16 _ 统计学基础:随机性是如何改变数据拟合的本质的?
- 17 _ 神经网络基础:神经网络还是复合函数
- 18 _ 神经网络基础:训练神经网络
- 19 _ 神经网络基础:神经网络的基础构成
- 20 _ Embedding简介:为什么Embedding更适合编码文本特征?
- 21 _ RNN简介:马尔可夫过程和隐马尔可夫过程
- 22 _ RNN简介:RNN和LSTM
- 23 _ CNN:卷积神经网络是什么?
- 24 _ 环境部署:如何构建简单的深度学习环境?
- 25 _ PyTorch简介:Tensor和相关运算
- 26 _ PyTorch简介:如何构造Dataset和DataLoader?
- 27 _ PyTorch简介:如何构造神经网络?
- 28 _ 文本分类实践:如何进行简单的文本分类?
- 29 _ 文本分类实践的评价:如何提升进一步的分类效果?
- 30 _ 经典的数据挖掘方法:数据驱动型开发早期的努力
- 31 _ 表格化数据挖掘基本流程:看看现在的数据挖掘都是怎么做的?
- 32 _ Pandas简介:如何使用Pandas对数据进行处理?
- 33 _ Matplotlib简介:如何进行简单的可视化分析?
- 34 _ 半自动特征构建方法:Target Mean Encoding
- 35 _ 半自动特征构建方法:Categorical Encoder
- 36 _ 半自动特征构建方法:连续变量的离散化
- 37 _ 半自动特征构建方法:Entity Embedding
- 38 _ 半自动构建方法:Entity Embedding的实现
- 39 _ 半自动特征构建方法:连续变量的转换
- 40 _ 半自动特征构建方法:缺失变量和异常值的处理
- 41 _ 自动特征构建方法:Symbolic learning和AutoCross简介
- 42 _ 降维方法:PCA、NMF 和 tSNE
- 43 _ 降维方法:Denoising Auto Encoders
- 44 _ 降维方法:Variational Auto Encoder
- 45 _ 变量选择方法
- 46 _ 集成树模型:如何提升决策树的效果
- 47 _ 集成树模型:GBDT和XgBoost的数学表达
- 48 _ 集成树模型:LightGBM简介
- 49 _ 集成树模型:CatBoost和NGBoost简介
- 50 _ 神经网络建模:如何让神经网络实现你的数据挖掘需求
- 51 _ 神经网络的构建:Residual Connection和Dense Connection
- 52 _ 神经网络的构建:Network in Network
- 53 _ 神经网络的构建:Gating Mechanism和Attention
- 54 _ 神经网络的构建:Memory
- 55 _ 神经网络的构建:Activation Function
- 56 _ 神经网络的构建:Normalization
- 57 _ 神经网络的训练:初始化
- 58 _ 神经网络的训练:学习率和Warm-up
- 59 _ 神经网络的训练:新的PyTorch训练框架
- 60 _ Transformer:如何通过Transformer榨取重要变量?
- 61 _ Transformer代码实现剖析
- 62 _ xDeepFM:如何用神经网络处理高维的特征?
- 63 _ xDeepFM的代码解析
- 64 _ 时序建模:如何用神经网络解决时间序列的预测问题?
- 65 _ 图嵌入:如何将图关系纳入模型?
- 66 _ 图网络简介:如何在图结构的基础上建立神经网络?
- 67 _ 模型融合基础:如何让你所学到的模型方法一起发挥作用?
- 68 _ 高级模型融合技巧:Metades是什么?
- 69 _ 挖掘自然语言中的人工特征:如何用传统的特征解决问题?
- 70 _ 重新审视Word Embedding:Negative Sampling和Contextual Embedding
- 71 _ 深度迁移学习模型:从ELMo到BERT
- 72 _ 深度迁移学习模型:RoBERTa、XLNet、ERNIE和T5
- 73 _ 深度迁移学习模型:ALBERT和ELECTRA
- 74 _ 深度迁移学习模型的微调:如何使用TensorFlow在TPU对模型进行微调
- 75 _ 深度迁移学习模型的微调:TensorFlow BERT代码简析
- 76 _ 深度迁移学习的微调:如何利用PyTorch实现深度迁移学习模型的微调及代码简析
- 77 _ 优化器:Adam和AdamW
- 78 _ 优化器:Lookahead,Radam和Lamb
- 79 _ 多重loss的方式:如何使用多重loss来提高模型准确率?
- 80 _ 数据扩充的基本方法:如何从少部分数据中扩充更多的数据并避免过拟合?
- 81 _ UDA:一种系统的数据扩充框架
- 82 _ Label Smoothing和Logit Squeezing
- 83 _ 底层模型拼接:如何让不同的语言模型融合在一起从而达到更好的效果?
- 84 _ 上层模型拼接:如何在语言模型基础上拼接更多的模型?
- 85 _ 长文本分类:截取、关键词拼接和预测平均
- 86 _ Virtual Adverserial Training:如何减少一般对抗训练难收敛的问题并提高结果的鲁棒性?
- 87 _ 其他Embedding的训练:还有哪些Embedding方法?
- 88 _ 训练预语言模型
- 89 _ 多任务训练:如何利用多任务训练来提升效果?
- 90 _ Domain Adaptation:如何利用其它有标注语料来提升效果?
- 91 _ Few-shot Learning:是否有更好的利用不同任务的方法?
- 92 _ 半监督学习:如何让没有标注的数据也派上用场?
- 93 _ 依存分析和Semantic Parsing概述
- 94 _ 依存分析和Universal Depdency Relattions
- 95 _ 如何在Stanza中实现Dependency Parsing
- 96 _ Shift Reduce算法
- 97 _ 基于神经网络的依存分析算法
- 98 _ 树神经网络:如何采用Tree LSTM和其它拓展方法?
- 99 _ Semantic Parsing基础:Semantic Parsing的任务是什么?
- 100 _ WikiSQL任务简介
- 101 _ ASDL和AST
- 102 _ Tranx简介
- 103 _ Lambda Caculus概述
- 104 _ Lambda-DCS概述
- 105 _ Inductive Logic Programming:基本设定
- 106 _ Inductive Logic Programming:一个可微的实现
- 107 _ 增强学习的基本设定:增强学习与传统的预测性建模有什么区别?
- 108 _ 最短路问题和Dijkstra Algorithm
- 109 _ Q-learning:如何进行Q-learning算法的推导?
- 110 _ Rainbow:如何改进Q-learning算法?
- 111 _ Policy Gradient:如何进行Policy Gradient的基本推导?
- 112 _ A2C和A3C:如何提升基本的Policy Gradient算法
- 113 _ Gumbel-trick:如何将离散的优化改变为连续的优化问题?
- 114 _ MCTS简介:如何将“推理”引入到强化学习框架中
- 115 _ Direct Policty Gradient:基本设定及Gumbel-trick的使用
- 116 _ Direct Policty Gradient:轨迹生成方法
- 117 _ AutoML及Neural Architecture Search简介
- 118 _ AutoML网络架构举例
- 119 _ RENAS:如何使用遗传算法和增强学习探索网络架构
- 120 _ Differentiable Search:如何将NAS变为可微的问题
- 121 _ 层次搜索法:如何在模块之间进行搜索?
- 122 _ LeNAS:如何搜索搜索space
- 123 _ 超参数搜索:如何寻找算法的超参数
- 124 _ Learning to optimize:是否可以让机器学到一个新的优化器
- 125 _ 遗传算法和增强学习的结合
- 126 _ 使用增强学习改进组合优化的算法
- 127 _ 多代理增强学习概述:什么是多代理增强学习?
- 128 _ AlphaStar介绍:AlphaStar中采取了哪些技术?
- 129 _ IMPALA:多Agent的Actor-Critic算法
- 130 _ COMA_Agent之间的交流
- 131 _ 多模态表示学习简介
- 132 _ 知识蒸馏:如何加速神经网络推理
- 133 _ DeepGBM:如何用神经网络捕捉集成树模型的知识
- 134 _ 文本推荐系统和增强学习
- 135 _ RL训练方法集锦:简介
- 136 _ RL训练方法_RL实验的注意事项
- 137 _ PPO算法
- 138 _ Reward设计的一般原则
- 139 _ 解决Sparse Reward的一些方法
- 140 _ Imitation Learning和Self-imitation Learning
- 141 _ 增强学习中的探索问题
- 142 _ Model-based Reinforcement Learning
- 143 _ Transfer Reinforcement Learning和Few-shot Reinforcement Learning
- 144 _ Quora问题等价性案例学习:预处理和人工特征
- 145 _ Quora问题等价性案例学习:深度学习模型
- 146 _ 文本校对案例学习
- 147 _ 微服务和Kubernetes简介
- 148 _ Docker简介
- 149 _ Docker部署实践
- 150 _ Kubernetes基本概念
- 151 _ Kubernetes部署实践
- 152 _ Kubernetes自动扩容
- 153 _ Kubernetes服务发现
- 154 _ Kubernetes Ingress
- 155 _ Kubernetes健康检查
- 156 _ Kubernetes灰度上线
- 157 _ Kubernetes Stateful Sets
- 158 _ Istio简介:Istio包含哪些功能?
- 159 _ Istio实例和Circuit Breaker
- 160 _ 结束语
同类课程
和你正在看的这门一个方向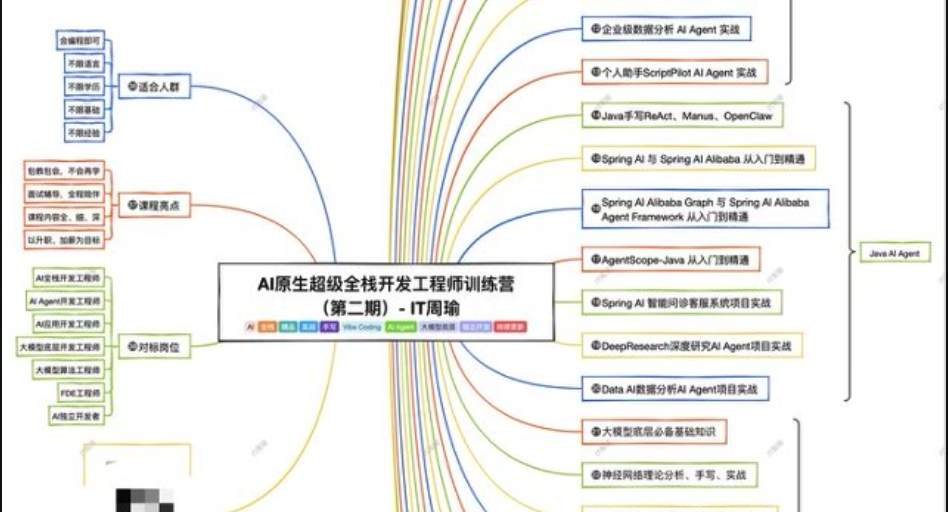 AI 查看详情
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI 查看详情
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI 查看详情
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货