 人工精选
IBM Cloud Pak for Data-加速人工智能之旅的神器免费课程
这门课解决什么工作场景 很多做数据分析和算法落地的同学会遇到一个现实困境:模型在本地环境里跑得很好,一旦要推到公司生产环境,就会陷入数据孤岛、权限隔离、环境依赖冲突的泥潭。这门围绕企业级数据与人工智能平台展开的资料,瞄准的就是这种从数据准备到模型部署的工程化断层。它不教你写算法公式,也不讲基础语法,
会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
这门课解决什么工作场景
很多做数据分析和算法落地的同学会遇到一个现实困境:模型在本地环境里跑得很好,一旦要推到公司生产环境,就会陷入数据孤岛、权限隔离、环境依赖冲突的泥潭。这门围绕企业级数据与人工智能平台展开的资料,瞄准的就是这种从数据准备到模型部署的工程化断层。它不教你写算法公式,也不讲基础语法,而是带你理解怎样在一个统一的容器化平台上,把分散在多个数据库里的数据汇聚起来、做探索性分析、再衔接模型训练和上线。如果你的日常工作卡在数据取数繁琐、跨部门数据打通困难、模型难以稳定部署,这批资料提供了一个具体的平台视角去拆解这些环节。
适合什么基础与建议先看哪几块
这套资料不面向零基础读者。它默认你已经清楚数据清洗的基本逻辑,对关系型数据库和容器化概念有基本认知,最好有过模型训练经历,现在正卡在如何把数据流转和模型迭代工程化上。如果是纯转行且刚接触编程,直接看会存在门槛。建议有一定基础的同学先看平台概述与产品演练这两块,建立对整体控制台和功能边界的直观认知;接着直接跳到数据收集与组织部分,看平台如何处理异构数据源的接入和编目;然后再看数据虚拟化那几节,这部分是解决跨库查询不搬砖的关键。容器底座那节建议和前面数据流转的内容对照着看,理解底层隔离机制如何支撑上层的数据操作。不要一上来就按顺序逐个刷,先抓住数据流转这条主线,能更快判断这个平台能否套用到你当前的实际业务里。
学完能独立做什么与资料怎么配合练习
看完这套资料后,你应该能独立在平台上完成一整套基础的数据链路打通:把多个业务系统的数据源接入平台,通过元数据目录进行组织梳理,利用虚拟化技术做跨源联合查询,而不需要把数据先导出到本地再处理。资料本身的时长不算长,属于高度浓缩的产品演示,单靠看视频很难形成肌肉记忆。正确的使用方法是把它当作操作指南,一边看一边在自己的测试环境里复刻演示动作。遇到数据组织环节,就停下来自己建几个模拟表结构去跑通编目流程;看到分析模块,就拿一份公开数据集导入试试查询性能。这种边看边动手的方式,才能把浓缩的演示转化为实际的工程操作能力,真正在后续工作中解决数据流转与模型衔接的痛点。
课程目录
课程目录14 集
- 1-1 [加速人工智能之旅的神器] IBM Cloud Pak for Data概述 (06:32).mp4
- 1-2 [加速人工智能之旅的神器] IBM Cloud Pak for Data - 产品演练 (08:40).mp4
- 1-3 [加速人工智能之旅的神器] IBM Cloud Pak for Data - 收集 (06:01).mp4
- 1-4 [加速人工智能之旅的神器] IBM Cloud Pak for Data - 组织 (08:44).mp4
- 1-5 [加速人工智能之旅的神器] IBM Cloud Pak for Data - 分析 (08:32).mp4
- 1-6 [加速人工智能之旅的神器] Cloud Pak for Data &OpenShift (08:47).mp4
- 1-7 [加速人工智能之旅的神器] Cloud Pak for Data-数据虚拟化 (08:44).mp4
- 1-8 [加速人工智能之旅的神器] Cloud Pak for Data中的集成数据库 (06:30).mp4
- 1-9 [加速人工智能之旅的神器] 使用 Watson™Studio 加速 AI 项目交付 (07:48).mp4
- 1-10 [加速人工智能之旅的神器] 使用 Watson™Studio 进行促销计划 (03:22).mp4
- 1-11 [加速人工智能之旅的神器] Cloud Pak for Data 与 MongoDB (05:05).mp4
- 1-12 [加速人工智能之旅的神器] 数据工程师的数据虚拟化历程 (06:28).mp4
- 1-13 [加速人工智能之旅的神器] Performance Server简介 (04:51).mp4
- 1-14 [加速人工智能之旅的神器] Performance Server 迁移及兼容 (04:39).mp4
同类课程
和你正在看的这门一个方向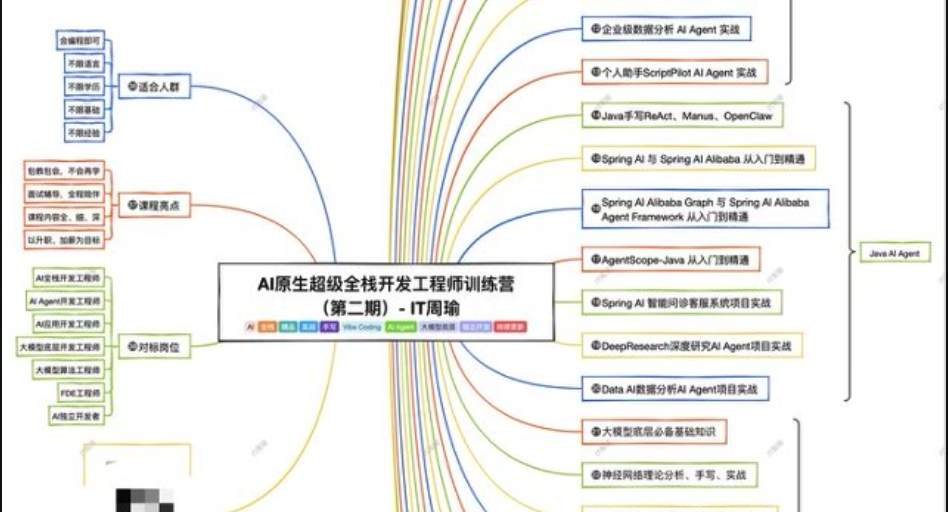 AI 查看详情
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI 查看详情
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI 查看详情
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货