 人工精选
强化学习实战系列(2020新版)
解决什么问题:从规则驱动到自主决策 这套资料聚焦的是强化学习领域,它解决的核心场景是:当业务环境无法用明确代码规则穷举,或者写死规则成本过高时,如何让程序通过与环境交互、试错并拿到奖励反馈,自主迭代出一套最优决策策略。相比监督学习需要海量人工标注数据,它更适合做序列决策。比如让AI在游戏对局里学会走
会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
解决什么问题:从规则驱动到自主决策
这套资料聚焦的是强化学习领域,它解决的核心场景是:当业务环境无法用明确代码规则穷举,或者写死规则成本过高时,如何让程序通过与环境交互、试错并拿到奖励反馈,自主迭代出一套最优决策策略。相比监督学习需要海量人工标注数据,它更适合做序列决策。比如让AI在游戏对局里学会走位、在机器人控制里学会平衡、在资源调度里学会分配,或者在某些推荐场景里根据用户长期反馈做动态调整。资料前半段用通俗图解和游戏演示把这套交互闭环讲透,后半段直接切入近端策略优化算法的推导,这是目前工业界落地最稳的一类策略梯度方法。
适合什么基础与建议学习顺序
它需要你具备Python编程基础,能看懂张量运算,且对概率论和微积分求导有基本概念。如果你只写过增删改查业务逻辑,没碰过深度学习框架,直接啃后半段公式会非常吃力。建议先从开篇的简介与工作流程看起,重点理解状态、行为、奖励这几个核心要素在计算机视角下怎么表达,把交互闭环跑通。第二部分是硬骨头,它从与环境交互拿数据开始,一步步推导策略梯度目标函数。看这段时不要死记符号,先弄清楚每一步推导是为了解决什么具体问题,比如为什么要引入重要性采样,新旧策略差异过大会导致什么训练崩溃。把推导过程在纸上自己过一遍,再对照视频回看,比单纯听讲吸收快得多。
学完能独立做什么与资料配合方式
学透之后,你能在给定的仿真环境里,独立搭建并训练一个能自主做连续决策的智能体。比如自己定义一个网格世界或简易对战环境,用这套近端策略优化算法让模型从随机乱动收敛到稳定通关,并能根据训练曲线排查是奖励设计不合理还是学习率过大。资料包里的推导讲解必须配合实际编码练习才能内化。建议每看完一个公式推导小节,就暂停视频,打开自己的编辑器,把对应的损失函数和梯度更新部分手写一遍,跑通极简验证。不要把资料当连续剧刷,它本质是数学推导加工程实现,只有自己动手把算法跑出收敛曲线,遇到环境报错和梯度异常时去查错,才算真正把这套决策框架握在手里,否则看完很容易只剩下一堆模糊的术语。
课程目录
课程目录82 集
- 1-1 [强化学习简介及其应用] 课程介绍 (02:54).mp4
- 1-2 [强化学习简介及其应用] 一张图通俗解释强化学习 (04:47).mp4
- 1-3 [强化学习简介及其应用] 强化学习的指导依据 (07:07).mp4
- 1-4 [强化学习简介及其应用] 强化学习AI游戏DEMO (04:48).mp4
- 1-5 [强化学习简介及其应用] 应用领域简介 (06:28).mp4
- 1-6 [强化学习简介及其应用] 强化学习工作流程 (05:48).mp4
- 1-7 [强化学习简介及其应用] 计算机眼中的状态与行为 (07:25).mp4
- 2-1 [PPO算法与公式推导] 基本情况介绍 (11:17).mp4
- 2-2 [PPO算法与公式推导] 与环境交互得到所需数据 (08:30).mp4
- 2-3 [PPO算法与公式推导] 要完成的目标分析 (10:40).mp4
- 2-4 [PPO算法与公式推导] 策略梯度推导 (09:01).mp4
- 2-5 [PPO算法与公式推导] baseline方法 (06:10).mp4
- 2-6 [PPO算法与公式推导] OnPolicy与OffPolicy策略 (07:44).mp4
- 2-7 [PPO算法与公式推导] importance sampling的作用 (08:31).mp4
- 2-8 [PPO算法与公式推导] PPO算法整体思路解析 (09:19).mp4
- 3-1 [策略梯度实战-月球登陆器训练实例] Critic的作用与效果 (10:39).mp4
- 3-2 [策略梯度实战-月球登陆器训练实例] PPO2版本公式解读 (11:45).mp4
- 3-3 [策略梯度实战-月球登陆器训练实例] 参数与网络结构定义 (08:04).mp4
- 3-4 [策略梯度实战-月球登陆器训练实例] 得到动作结果 (07:17).mp4
- 3-5 [策略梯度实战-月球登陆器训练实例] 奖励获得与计算 (08:08).mp4
- 3-6 [策略梯度实战-月球登陆器训练实例] 参数迭代与更新 (11:03).mp4
- 4-1 [Q-learning算法] 算法原理通俗解读 (07:11).mp4
- 4-2 [Q-learning算法] 目标函数与公式解析 (10:07).mp4
- 4-3 [Q-learning算法] Qlearning算法实例解读 (07:45).mp4
- 4-4 [Q-learning算法] Q值迭代求解 (08:59).mp4
- 4-5 [Q-learning算法] DQN简介 (05:07).mp4
- 5-1 [DQN算法实例演示] 整体任务流程演示 (05:21).mp4
- 5-2 [DQN算法实例演示] 探索与action获取 (06:58).mp4
- 5-3 [DQN算法实例演示] 计算target值 (05:17).mp4
- 5-4 [DQN算法实例演示] 训练与更新 (08:12).mp4
- 6-1 [DQN改进与应用技巧] DoubleDqn要解决的问题 (06:47).mp4
- 6-2 [DQN改进与应用技巧] DuelingDqn改进方法 (06:26).mp4
- 6-3 [DQN改进与应用技巧] Dueling整体网络架构分析 (08:27).mp4
- 6-4 [DQN改进与应用技巧] MultiSetp策略 (03:45).mp4
- 6-5 [DQN改进与应用技巧] 连续动作处理方法 (08:23).mp4
- 7-1 [Actor-Critic算法分析(A3C)] AC算法回顾与知识点总结 (07:18).mp4
- 7-2 [Actor-Critic算法分析(A3C)] 优势函数解读与分析 (07:12).mp4
- 7-3 [Actor-Critic算法分析(A3C)] 计算流程实例 (05:50).mp4
- 7-4 [Actor-Critic算法分析(A3C)] A3C整体架构分析 (06:01).mp4
- 7-5 [Actor-Critic算法分析(A3C)] 损失函数整理 (08:32).mp4
- 8-1 [A3C算法玩转超级马里奥] 整体流程与环境配置 (05:38).mp4
- 8-2 [A3C算法玩转超级马里奥] 启动游戏环境 (06:59).mp4
- 8-3 [A3C算法玩转超级马里奥] 初始化局部模型并加载参数 (08:05).mp4
- 8-4 [A3C算法玩转超级马里奥] 要计算的指标回顾 (09:01).mp4
- 8-5 [A3C算法玩转超级马里奥] 与环境交互得到训练数据 (09:31).mp4
- 8-6 [A3C算法玩转超级马里奥] 训练网络模型 (09:39).mp4
- 9-1 [算法补充-卷积神经网络原理与参数解读] 卷积神经网络应用领域 (07:24).mp4
- 9-2 [算法补充-卷积神经网络原理与参数解读] 卷积的作用 (09:23).mp4
- 9-3 [算法补充-卷积神经网络原理与参数解读] 卷积特征值计算方法 (08:07).mp4
- 9-4 [算法补充-卷积神经网络原理与参数解读] 得到特征图表示 (06:58).mp4
- 9-5 [算法补充-卷积神经网络原理与参数解读] 步长与卷积核大小对结果的影响 (08:11).mp4
- 9-6 [算法补充-卷积神经网络原理与参数解读] 边缘填充方法 (06:30).mp4
- 9-7 [算法补充-卷积神经网络原理与参数解读] 特征图尺寸计算与参数共享 (07:02).mp4
- 9-8 [算法补充-卷积神经网络原理与参数解读] 池化层的作用 (05:38).mp4
- 9-9 [算法补充-卷积神经网络原理与参数解读] 整体网络架构 (06:20).mp4
- 9-10 [算法补充-卷积神经网络原理与参数解读] VGG网络架构 (06:16).mp4
- 9-11 [算法补充-卷积神经网络原理与参数解读] 残差网络Resnet (07:41).mp4
- 9-12 [算法补充-卷积神经网络原理与参数解读] 感受野的作用 (05:46).mp4
- 10-1 [基础补充-PyTorch框架基本处理操作] PyTorch框架发展趋势简介 (08:25).mp4
- 10-2 [基础补充-PyTorch框架基本处理操作] 框架安装方法(CPU与GPU版本) (05:13).mp4
- 10-3 [基础补充-PyTorch框架基本处理操作] PyTorch基本操作简介 (09:25).mp4
- 10-4 [基础补充-PyTorch框架基本处理操作] 自动求导机制 (10:59).mp4
- 10-5 [基础补充-PyTorch框架基本处理操作] 线性回归DEMO-数据与参数配置 (08:56).mp4
- 10-6 [基础补充-PyTorch框架基本处理操作] 线性回归DEMO-训练回归模型 (10:08).mp4
- 10-7 [基础补充-PyTorch框架基本处理操作] 常见tensor格式 (07:10).mp4
- 10-8 [基础补充-PyTorch框架基本处理操作] Hub模块简介 (08:25).mp4
- 11-1 [基础补充-PyTorch图像识别实例] 卷积网络参数定义 (07:21).mp4
- 11-2 [基础补充-PyTorch图像识别实例] 网络流程解读 (07:26).mp4
- 11-3 [基础补充-PyTorch图像识别实例] Vision模块功能解读 (05:10).mp4
- 11-4 [基础补充-PyTorch图像识别实例] 分类任务数据集定义与配置 (06:27).mp4
- 11-5 [基础补充-PyTorch图像识别实例] 图像增强的作用 (04:51).mp4
- 11-6 [基础补充-PyTorch图像识别实例] 数据预处理与数据增强模块 (09:25).mp4
- 11-7 [基础补充-PyTorch图像识别实例] Batch数据制作 (08:37).mp4
- 11-8 [基础补充-PyTorch图像识别实例] 迁移学习的目标 (05:31).mp4
- 11-9 [基础补充-PyTorch图像识别实例] 迁移学习策略 (07:11).mp4
- 11-10 [基础补充-PyTorch图像识别实例] 加载训练好的网络模型 (09:54).mp4
- 11-11 [基础补充-PyTorch图像识别实例] 优化器模块配置 (05:14).mp4
- 11-12 [基础补充-PyTorch图像识别实例] 实现训练模块 (08:15).mp4
- 11-13 [基础补充-PyTorch图像识别实例] 训练结果与模型保存 (09:31).mp4
- 11-14 [基础补充-PyTorch图像识别实例] 加载模型对测试数据进行预测 (09:10).mp4
- 11-15 [基础补充-PyTorch图像识别实例] 额外补充-Resnet论文解读 (11:47).mp4
- 11-16 [基础补充-PyTorch图像识别实例] 额外补充-Resnet网络架构解读 (08:26).mp4
同类课程
和你正在看的这门一个方向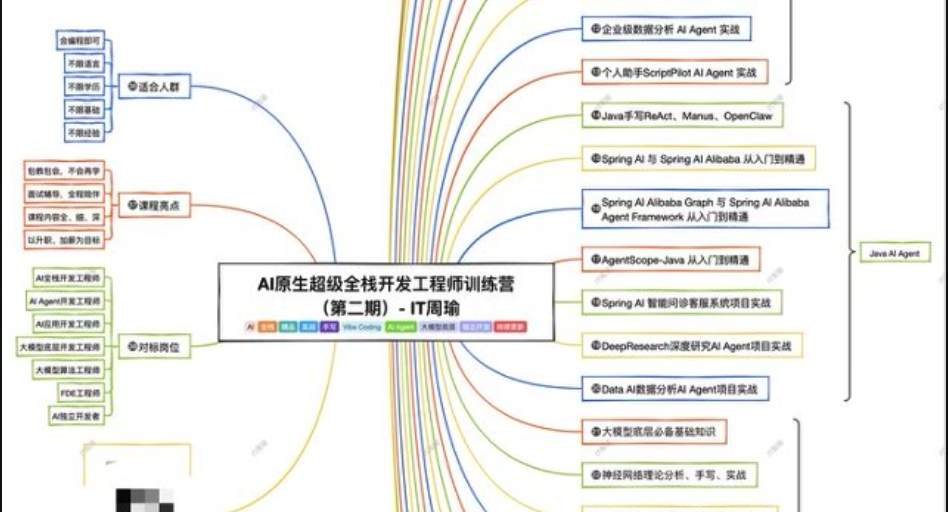 AI 查看详情
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI 查看详情
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI 查看详情
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货