 人工精选
黑马狂野大模型4期nlp项目分享
这套资料围绕大模型在自然语言处理方向的落地展开,主体是一条完整的文本分类项目线,从环境准备、数据处理到模型训练与调优都有对应的讲解片段。它不是那种从机器学习数学基础讲起的通识课,而是假设你已经能跑通 Python 代码,直接带你把一个分类任务做出来。 它解决的是哪类工作场景 实际工作里,NLP 需求
会员可免费下载本篇月会员可免费领取。
开通会员 ›会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
这套资料围绕大模型在自然语言处理方向的落地展开,主体是一条完整的文本分类项目线,从环境准备、数据处理到模型训练与调优都有对应的讲解片段。它不是那种从机器学习数学基础讲起的通识课,而是假设你已经能跑通 Python 代码,直接带你把一个分类任务做出来。
它解决的是哪类工作场景
实际工作里,NLP 需求有相当一部分可以归到文本分类:工单自动打标、评论情感判断、内容审核分级、意图识别。这类任务的共同点是标签体系明确、样本可以人工标注、评估指标好定义。资料里的项目正是沿着这个思路走的,把一条从原始文本到可预测模型的链路拆开讲。如果你手头正好有类似的分分类需求,或者面试时被问到「做过什么 NLP 项目」,这条线能直接对上。它不涉及大模型预训练、分布式训练这类偏底层的内容,所以不要指望学完能去做基座模型。
适合什么基础,先看哪几块
比较合适的起点是:会 Python,用过 PyTorch 或至少看过训练循环的代码,知道什么是训练集验证集。如果连张量操作都不熟,建议先补基础再回来,否则跟着敲也会卡住。资料按天组织,前几天的内容偏环境搭建和数据准备,中间进入模型部分,后面是分类项目的反复打磨。建议先看项目主体那一段,把整体流程跑通一遍,再回头补前面的细节。这样做的原因是,先有全局观,后面看零散知识点时才知道它挂在链条的哪个位置。测试相关的片段可以最后看,用来验证自己的理解。
学完能独立做什么,资料怎么配合练
把项目跟完一遍,你应该能独立完成这样一件事:拿到一批带标签的文本,自己写清洗和分词逻辑,构建数据集,选一个预训练模型做微调,跑出准确率和混淆矩阵,再根据结果判断是数据问题还是模型问题。这个能力在中小型 NLP 需求里已经够用。练习方式上,不建议只看不写。可以拿自己行业的文本另做一份数据集,比如把公司内部的问题记录按类型打标,复用同一套流程跑一遍。跑通之后再尝试换模型、调学习率、改最大长度,观察指标变化。资料里的代码是参照,不是标准答案,改动过程中遇到的报错才是真正学到东西的地方。如果时间有限,优先保证项目主线完整跑通,测试和边角内容可以跳过,不要为了看完而看完。
课程目录
大模型 📁 投满分项目itcast后缀 📁 00-test 📁 day6 集
- 01 📁 day
- 02 📁 day
- 03 📁 day
- 04 📁 day
- 05 📁 toumanfen 📁 投满分项目sz后缀
- 33 文本分类项目 .mp4
- 34 文本分类项目 .mp4
- 35 文本分类项目 .mp4
- 36 文本分类项目 .mp4
- 37 文本分类项目 .mp4
- 38 文本分类项目 .mp4
- 适合人群 AI爱好者 NLP初学者 数据科学家 学习收获 掌握大模型NLP应用 提升文本处理能力 完成实战项目 祝您学习愉快! 学有所成,前程似锦!
同类课程
和你正在看的这门一个方向 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI
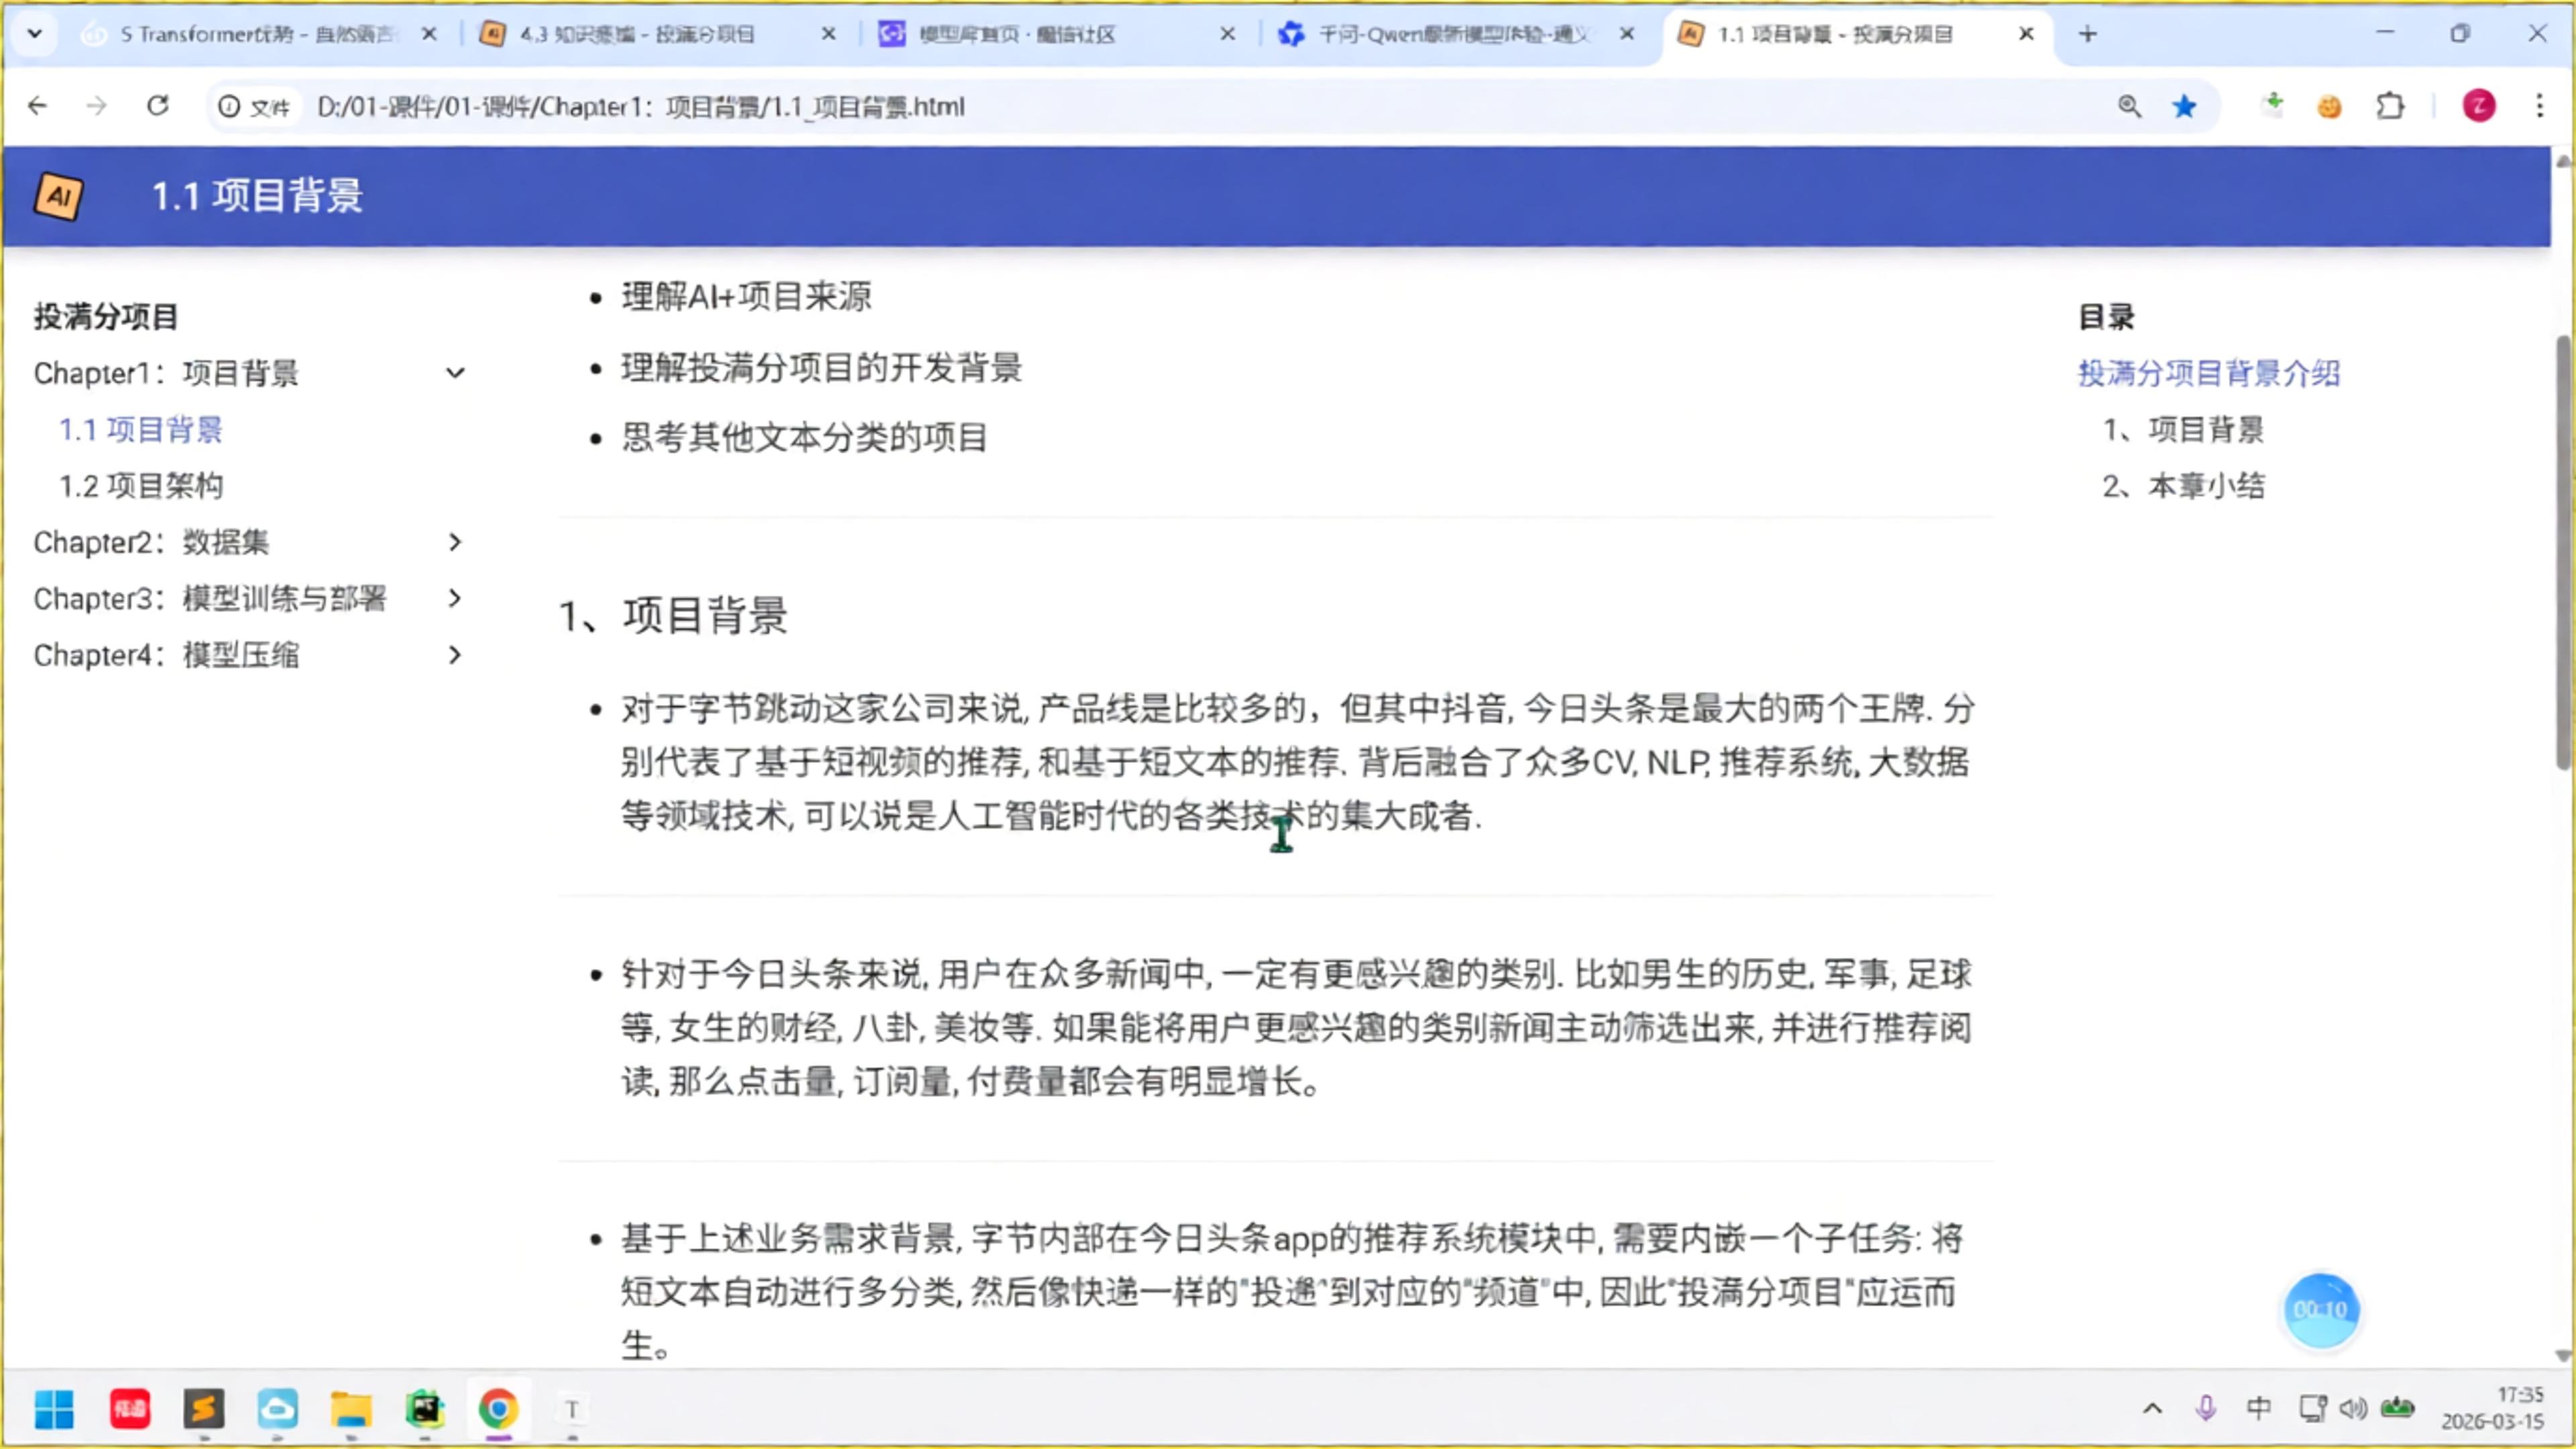
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI
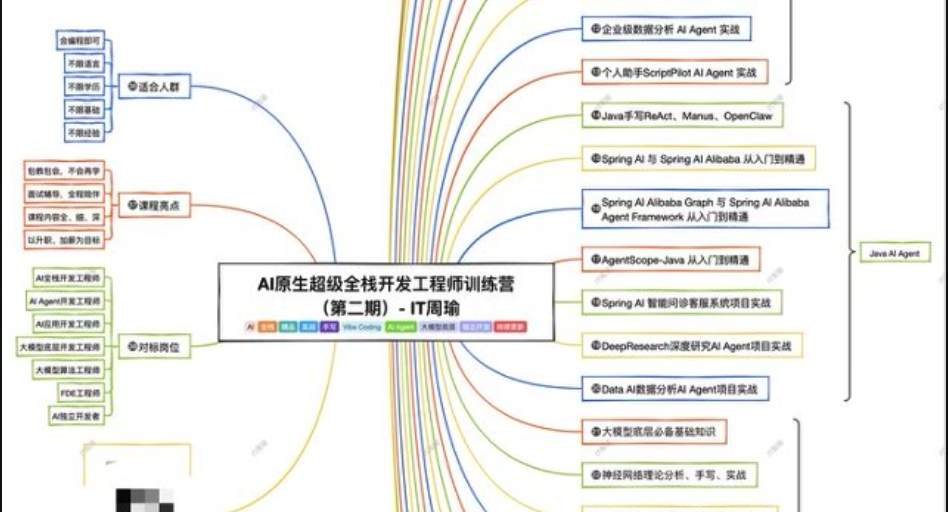
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货