 人工精选
唐宇迪《Agent实战课程》
这门课围绕一个具体目标展开:让你能自己动手搭出一个能感知环境、做出决策、并从反馈里调整策略的 Agent,而不是停在"知道强化学习有几个要素"的层面。它把深度学习和强化学习两条线并到一起讲,重点落在 Agent 的构建与训练流程上。如果你之前看过一些强化学习的概念讲解,却在"怎么把算法跑起来、怎么让
会员可免费下载本篇月会员可免费领取。
开通会员 ›会员 · 按档位
游客按标价购买,不享受上表折扣。
支付成功后自动发放网盘链接,链接失效可找客服免费补
这门课围绕一个具体目标展开:让你能自己动手搭出一个能感知环境、做出决策、并从反馈里调整策略的 Agent,而不是停在"知道强化学习有几个要素"的层面。它把深度学习和强化学习两条线并到一起讲,重点落在 Agent 的构建与训练流程上。如果你之前看过一些强化学习的概念讲解,却在"怎么把算法跑起来、怎么让智能体真的学会一件事"上卡住,这门课针对的就是这个断点。
先确认它解决的是哪类问题
日常工作中,很多所谓"AI 项目"其实是把预训练模型包一层接口,调参、拼流程,谈不上决策。而 Agent 类任务不一样:它要求系统在连续状态下选择动作,并根据回报优化长期表现。这门课处理的正是这一类场景——比如让智能体在给定环境里学会完成任务、在试错中收敛策略。它不承诺你学完就能做出通用智能体,也不涉及大模型工具调用那套工程编排,重心放在深度学习与强化学习结合的经典 Agent 训练方法上。想学的是"怎么让模型自己学会做决策",方向就对;想学的是"怎么用现成框架拼一个问答助手",方向就偏。
适合什么基础,建议从哪几块入手
最舒服的起点是:会 Python,能看懂张量和反向传播在做什么,知道神经网络训练的基本流程。如果连损失函数、梯度下降都没写过代码,建议先把这部分补上再进来,否则强化学习里的策略更新会很吃力。纯零基础也能看,但需要边看边补,节奏会慢一些。
建议的观看顺序不是从第一集顺着播。先把深度学习相关的基础部分快速过一遍,确认环境配置、训练循环、模型保存这些环节自己能复现;然后进入强化学习的概念部分,把状态、动作、回报、策略这几个词的含义对齐;最后重点放在 Agent 构建与训练的实战环节,这部分才是这门课真正的价值所在。前沿技术解析那一块可以放到后面当补充,不必一上来就啃。
学完能独立做什么,资料怎么配合练
按正常投入,学完你应该能独立完成这些事:为一个自定义的小环境定义状态和动作空间,选择合适的策略表示方式,写出训练循环并让它收敛;能读懂训练曲线,判断是探索不足、回报设计有问题还是超参不合适;能把训练好的策略保存下来并复现结果。这些能力足以支撑你自己做一个小型决策类项目,也够用来判断别人给的 Agent 方案是否靠谱。
资料的使用上,别只看不写。每看完一个实战模块,先自己把代码敲一遍,再尝试改一个变量——换回报函数、调探索率、改网络层数,观察结果怎么变。强化学习对随机性敏感,同一个设置跑两次结果可能不同,所以要养成固定随机种子、多跑几次取平均的习惯。遇到不收敛先别急着换算法,先检查回报设计和状态表示,这两处出问题的概率远高于算法本身。学完一个阶段后,找一个自己熟悉的小场景试着建模成决策问题,哪怕很简单,也比重复跑示例更能检验是否真的掌握。
课程目录
唐宇迪《Agent实战课程》 深度学习与强化学习实战指南 编辑点评 深入浅出,实战性强,适合初学者快速上手。 ⭐ 编辑推荐 唐宇迪老师带你从零开始,掌握Agent构建与训练技巧。 课程涵盖深度学习、强化学习等前沿技术,实战项目丰富。 课程亮点 • 深度学习与强化学习实战 • Agent构建与训练 • 前沿技术解析 适合人群 AI初学者 机器学习爱好者 算法工程师 学习收获 掌握Agent构建方法 学会强化学习应用 提升AI项目实战能力 祝您学习愉快! 学有所成,前程似锦!
同类课程
和你正在看的这门一个方向 AI
慕课网 - AI Agent全栈开发工程师(完整版)
永久有效 · 网盘发货
 AI
咕泡第五期-AI大模型零基础到商业实战全栈课
永久有效 · 网盘发货
 AI
黑马26年最新 ai V7.5 线上全套
永久有效 · 网盘发货
 AI
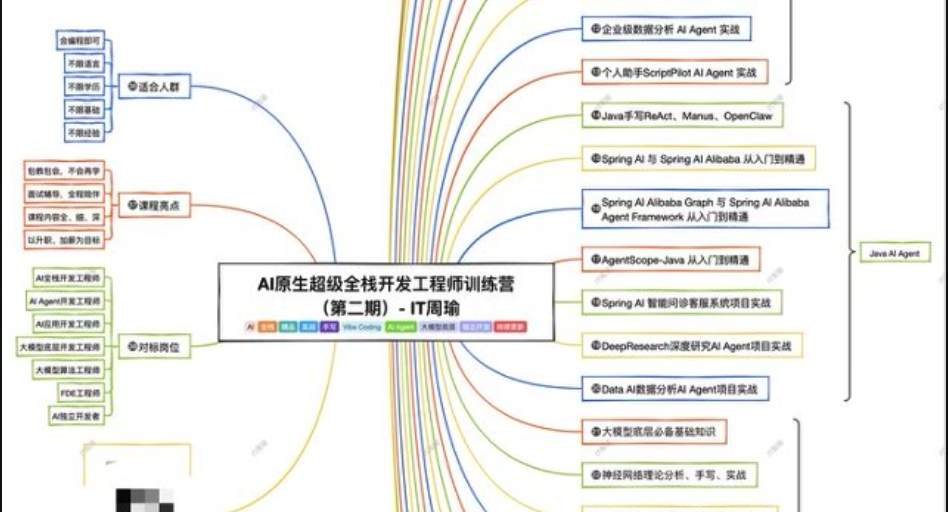
IT周瑜-AI原生超级全栈开发工程师训练营【第二期】
永久有效 · 网盘发货
 AI
大漂亮《自媒体影响力变现集训营》
永久有效 · 网盘发货
 AI
Hermes Agent从入门到AI数字员工实战|已完结
永久有效 · 网盘发货